RL Course Notes (Part 2)#
第二章: 状态值(State Value)和贝尔曼方程(Bellman Equation)#
回报与策略#
衡量一个策略好与坏的直接方式就是写出从起点到Target的轨迹然后计算回报, 以书上的一个简单例子来说明
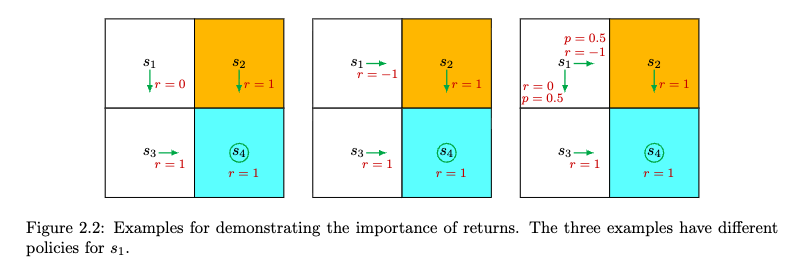
图上已经写明了三种策略和Reward了, 注意这三条轨迹都是无穷轨迹, 因为走到了Target之后他们都会不定的原地打转, 所以算回报的时候要算无穷级数的和
计算过程就省略了(不记得了可以去翻翻数学分析算级数的那部分), 结果是
Return1=1−γγReturn2=−1+1−γγReturn3=−0.5+1−γγ
所以
Return1>Return3>Return2
所以策略1是最好的, 策略2是最差的
计算回报的方法#
书上给了一个比较特殊的例子:
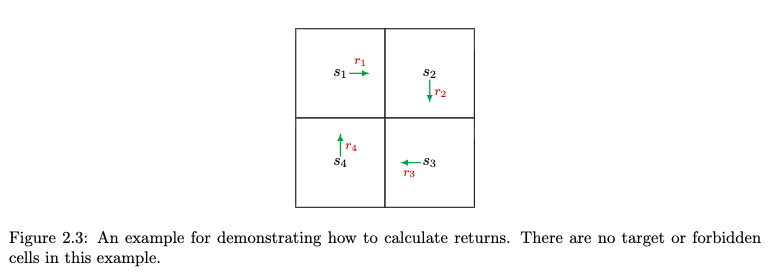
以vi记状态si的回报, 根据之前的公式”回报为之后的所有奖励求无穷和”可以得到
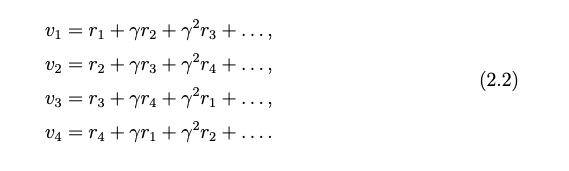
每一行里面又可以做迭代(注意前面已经证明了在有折扣因子γ存在的条件下, 级数是绝对收敛的, 所以这个迭代可以进行)
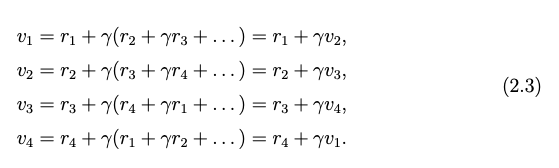
这样一来, 得到一个可解的线性非其次方程组, 可以通过Gauss消元或者矩阵代数的方法去解这个方程组:
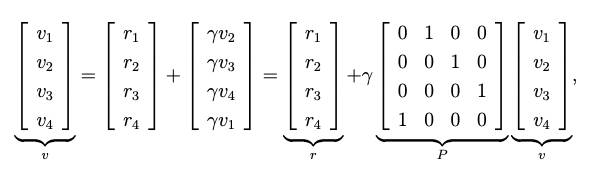
实际上就是矩阵方程
v=r+γPvv=(E−γP)−1r
这就是这个简单例子的贝尔曼方程, 实际上针对任意的情况, 思路都是一样的, 也就是状态的回报是相互依赖的, 所以总能写成一个可解的矩阵方程的形式
状态值(State Value)#
我们先引入一种notation, 用来描述状态之间的转换, 用自然语言描述就是: 在状态St执行了策略π输出的动作At, 然后状态转移到了St+1, 并获得了立即奖励Rt+1
StAtSt+1,Rt+1
不严格的证明, 这里的St,St+1,At,Rt+1都是随机变量, 因为他们都是从一系列的状态空间当中抽取出来的
所以对于任意的t, 我们可以得到一条从St出发的轨迹:
StAtSt+1,Rt+1At+1St+2,Rt+2At+2...
根据前面的定义, t状态下(或者说从t状态出发)的折扣回报(沿着这条轨迹)为
Gt=Rt+1+γRt+2+γ2Rt+3+...
Gt也是随机变量, 所以可以对他求期望, 同时注意到Gt依赖于St, 所以可以用以下的条件期望来表示:“在某种状态下执行某种策略所得到的折扣回报的期望”
vπ(s)=E[Gt∣St=s]
之所以有期望这个说法是因为就算给定了策略和状态t, 每次的轨迹是一个采样而不是一个确定性的东西(因为策略可能会以概率输出不同的动作)
注意他是不依赖于时间t的, 实际上可以这么想, 无论在什么时间, 只要给定策略, 走到s这个状态, vπ(s)就已经确定了, 实际上他只依赖于策略和状态
贝尔曼方程#
前面讲了一个简单例子的贝尔曼方程, 现在进行一般情况下的抽象推导:
Gt=Rt+1+γRt+2+γ2Rt+3+...=Rt+1+γGt+1
第二个等号的迭代来自于级数的绝对收敛性
再考虑状态值的定义
vπ(s)=E[Gt∣St=s]=E[Rt+1+γGt+1∣St=s]=E[Rt+1∣St=s]+γE[Gt+1∣St=s]
最后一个等号来自于期望的线性性质, 接下来可以对两项进行拆分:
E[Rt+1∣St=s]=a∈A∑π(a∣s)E[Rt+1∣St=s,At=a]=a∈A∑π(a∣s)r∈R∑p(r∣s,a)r
这里其实就是两次应用期望的定义, 要搞清楚获得这个Rt+1其实需要双重的概率, 一个是”做什么动作”的概率, 一个是”这个动作获得什么奖励”的概率, 所以只需要进行两次求和即可
对于第二项也是同样的道理, 先按照状态拆分, 这里需要一点trick, 我们可以给这个期望的条件”加上一个”:
E[Gt+1∣St=s]=s′∈S∑E[Gt+1∣St=s,St+1=s′]p(s′∣s)=s′∈S∑E[Gt+1∣St+1=s′]p(s′∣s)=s′∈S∑vπ(s′)p(s′∣s)=s′∈S∑vπ(s′)a∈A∑π(a∣s′)p(s′∣s,a)
套路都是一样的, 只要注意第二个等号是由于马尔可夫性质就好
综合以上两项然后提取出公因子, 就得到一般形式的贝尔曼方程:
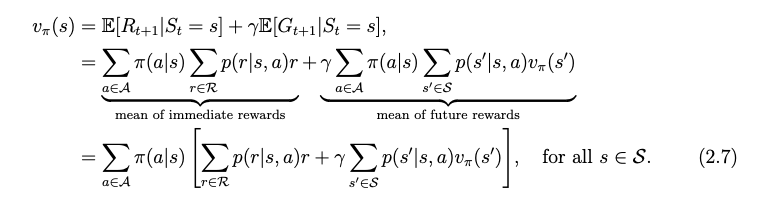
接下来要明确贝尔曼方程里什么是已知的, 什么是要求的
vπ(s)和vπ(s′)是未知的, 也是最后要解的, 这必须通过联立所有的状态的贝尔曼方程来解决(类似前面例子里面的矩阵代数求解)
π(a∣s)是已知的, 因为他是策略, 是给定的
p(r∣s,a)和p(s′∣s,a)是已知的, 因为他是环境模型, 是给定的
r是已知的, 因为他是奖励函数, 是给定的
贝尔曼方程和例子当中的直觉#
我们通过一些例子, 用直觉来感知贝尔曼方程的理论
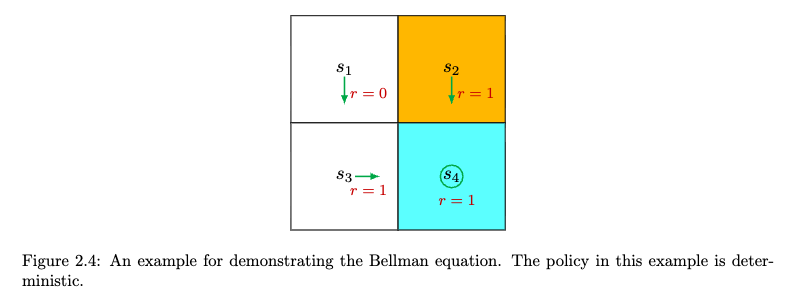
上图例子当中, 策略是确定性的, 我们用一些条件概率来刻画策略的行为和状态转移的行为:
π(a=a3∣s1)=1π(a=a3∣s1)=0p(s′=s3∣s1,a3)=1p(s′=s3∣s1,a3)=0p(r=0∣s1,a3)=1p(r=0∣s1,a3)=0
以上概率刻画了从s1出发到s3的所有变量, Recall一下贝尔曼方程
取s=s1,s′=s3, 等式变为:
vπ(s1)=0+γ⋅vπ(s3)
光这一个方程是结不出两个状态值的, 所以需要联立所有的贝尔曼方程来解:
vπ(s2)=1+γ⋅vπ(s4)vπ(s3)=1+γ⋅vπ(s4)vπ(s4)=1+γ⋅vπ(s4)
注意为什么右侧式子总是如此简单, 因为这里的概率分布非常容易, 所有求和号下总是一项为1其他为0, 所以每个求和号下其实都只剩下一项了
根据上面的四元方程组可以解出四个状态值, 过程略
考虑稍微复杂一点的情况, 如果策略不是确定性的, 而是带概率的, 那么此时一个求和号下可能会有若干项, 但是本质上都是一样的
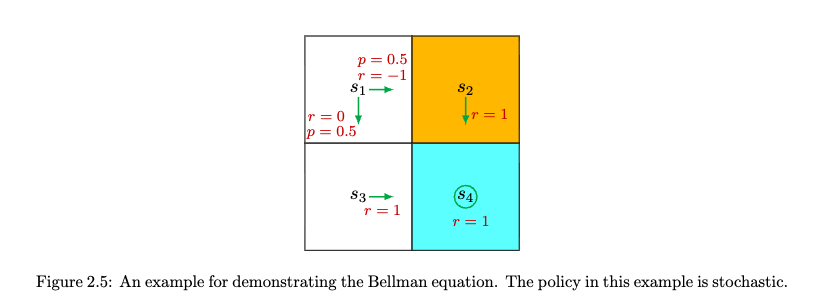
概率刻画为:
π(a=a2∣s1)=0.5π(a=a3∣s1)=0.5p(s′=s3∣s1,a3)=1p(s′=s2∣s1,a2)=1p(r=0∣s1,a3)=1p(r=−1∣s1,a2)=1
贝尔曼方程组为:
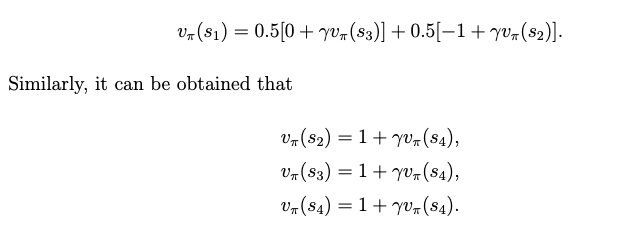
可得解
以上的简单例子说明了从直觉角度去理解贝尔曼方程的方式: s处的状态值取决于现在立刻得到的一个奖励加上未来状态的折扣回报, 即期奖励是动作概率和奖励概率双重加权的求和, 远期奖励是动作概率和状态转移概率双重加权的求和
矩阵形式的贝尔曼方程组#
首先引入如下的notation:
rπ(s)=a∈A∑π(a∣s)r∈R∑p(r∣s,a)rpπ(s′∣s)=a∈A∑π(a∣s)p(s′∣s,a)
也许这个记法有一点难理解, 其实只要记住一点就好, 就是把求和式子写成变量的函数的时候, 函数只取决于不在求和号底下的那些变量
第一行的变量有a,s,r, 而a,r都被求和了, 所以是s的函数, 第二行同理
所以贝尔曼方程被改写为:
vπ(s)=rπ(s)+γs′∈S∑pπ(s′∣s)vπ(s′)
当左边的s取遍状态空间S的时候, 就得到了一个方程组:
vπ(si)=rπ(si)+γsj∈S∑pπ(sj∣si)vπ(sj)
接下来只要引入向量记号即可:
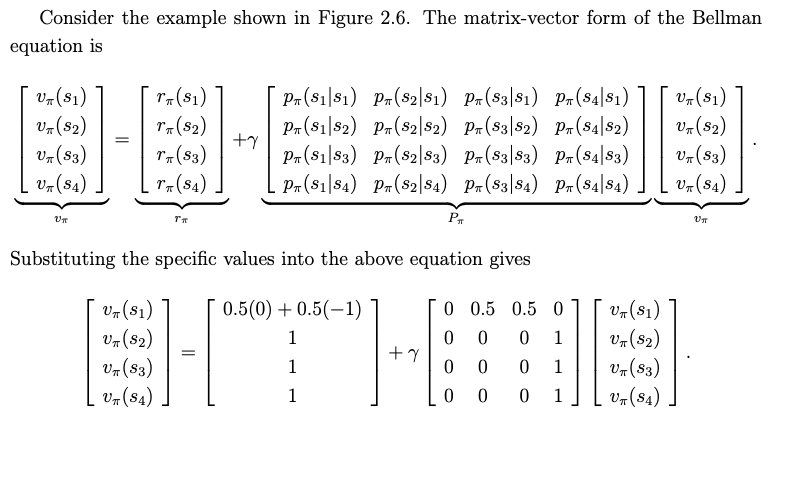
vπ=(vπ(s1),vπ(s2),...,vπ(s∣S∣))Trπ=(rπ(s1),rπ(s2),...,rπ(s∣S∣))T[Pπ]ij=pπ(sj∣si)
于是贝尔曼方程组被改写为:
vπ=rπ+γPπvπ
这个方程组是一个线性方程组, 可以解出vπ
前面那个随机策略的例子也可以用这个向量形式一步写出方程组:
贝尔曼方程组的解#
最直接的方式是矩阵代数给出的闭式解
vπ=(I−γPπ)−1rπ
关于为什么上面这个矩阵一定可逆, 书上给出了证明, 或者也可以当作一个高代习题去做
还有一种是可以用于离散场合下的递推法, 给出一个初始值vπ0, 然后迭代:
vπk+1=rπ+γPπvπk
最后会有
vk→vπask→∞
动作值(Action Value)#
回忆一下状态值的定义:
vπ(s)=E[Gt∣St=s]
即: 从状态s出发, 按照策略π所得到的折扣回报的期望
动作值的定义与之类似, 只不过是多了一个动作a的维度:
qπ(s,a)=E[Gt∣St=s,At=a]
注意条件概率的定义, 动作值是状态和动作的函数, 实际上动作值和状态值之间有以下关系:
vπ(s)=E[Gt∣St=s]=a∈A∑π(a∣s)E[Gt∣St=s,At=a]=a∈A∑π(a∣s)qπ(s,a)
注意状态值的另一种表达
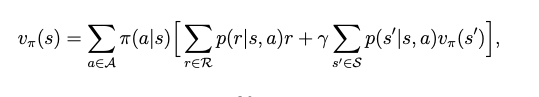
所以对比一下就可以得到:
qπ(s,a)=r∈R∑p(r∣s,a)r+γs′∈S∑p(s′∣s,a)vπ(s′)
所以本质上动作值就是状态值脱掉了外面那层动作的权重, 其余的求和都是一样的, 这也就意味着如果我们知道了状态值, 可以轻松的求到动作值
动作值的贝尔曼方程#
将动作值与状态值的方程中的状态值替换成动作值的表达方式:
qπ(s,a)=r∈R∑p(r∣s,a)r+γs′∈S∑p(s′∣s,a)a′∈A(s′)∑π(a′∣s′)qπ(s′,a′)
注意(s,a)的取值范围是状态空间和动作空间的笛卡尔积, 所以这里换成向量形式的时候, 都是Card(S)×Card(A)维的向量
qπ=r~+γP∏qπ
其中 qπ 是动作值向量,下标(s,a)表示状态动作对;r~ 是即时奖励向量,[r~](s,a)=∑r∈Rp(r∣s,a)r;P 是状态转移矩阵,[P](s,a),s′=p(s′∣s,a);Π 是块对角矩阵,每块为对应状态的策略向量 [Π]s′,(s′,a′)=π(a′∣s′)。