RL Course Notes (Part 1)#
课程简介#
本课程使用的是西湖大学赵世钰老师的 “强化学习的数学原理” 课程, B站链接为官方课程链接 ↗, 书的官方仓库为课本官方repo ↗
本课程为理论课, 几乎无代码, 实际上现在学RL的coding比理论也快得多, 毕竟天天让Agent写RL的各种组件, 看多了总归是”熟读唐诗三百首, 不会吟诗也会吟”
学习动机#
最近在FeelingAi做Research Intern, 第一篇文章的Idea(向我的带教潘薪宇博士致敬)就是关于如何使用RL让Agent自己决策Agent Memory的”增删查改”, 事实上我觉得很多算法的idea都是比较直观的, 但是在设计RL的过程中, 我对其背后原理没什么理解, 于是过来补课
之前我有看过一些别人写的notes, 其实RL用到的数学知识并不难(无非工科一二年级三件套), 问题就是notation写的太垃圾让人看不懂. 我感觉工科Researcher并不在乎他们写的equation 是否真的能让人轻松看懂(可能确实也没什么人去看毕竟paper里面放一个equation会减少50%的读者, 再放一个会再减少50%), 或者因为本身equation就不多, 大不了别人看不懂的时候他再去解释, 我觉得这是个非常不好的习惯, 尤其是对于Junior Researcher和 想学习算法背后数学原理的人来说, 会让学习效率大打折扣。
最后不得不说, 能把RL的math notation写的看起来比PDE还复杂, 确实是有点艺术细胞在身上的。
第一章: 基本概念#
例子: 机器人走格子#
RL当中有一些概念, 用一个经典的例子:grid world example(机器人走格子)来解释
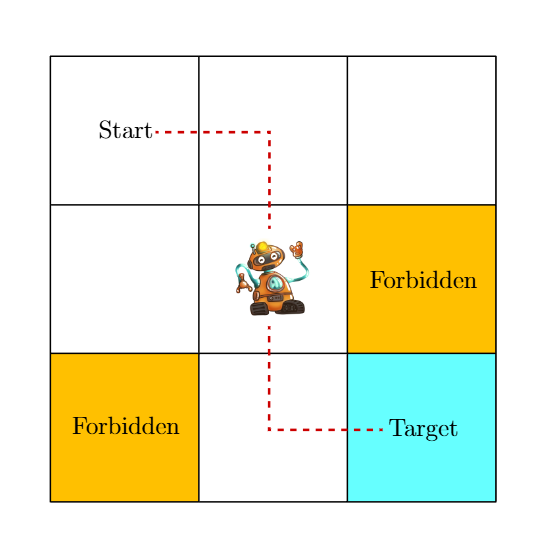
机器人从Start出发, 每次走一格, 那显然在每一格上都有很多的选择, 比如往上下左右走一格, 或者原地保持不动, 在RL中把这个可以自己做出决策(动作)的机器人叫做Agent
有一个初始状态(Start), 一个最终目标(Target)和一些我们不希望Agent(用来指代这个机器人)走进的地方
我们的RL算法就是要找到, 或者说推理出一个好的动作序列, 让Agent从Start走到Target
在这个例子里面, “好”是比较好衡量的, 明显Agent如果不撞墙, 不走到Forbidden Area里面并且尽快的走到Target就是好的。这个例子里的格子叫做Environment(环境), 显然Agent是知道环境的全貌的, 从而可以轻松的弄出一个好的算法, 但如果不知道环境的全部, 而只是能在和环境交互(比如走到某个新的格子里面)的时候得到一个反馈, 那要找一个最优算法也许就不容易了。
概念: State(状态)和Action(动作)#
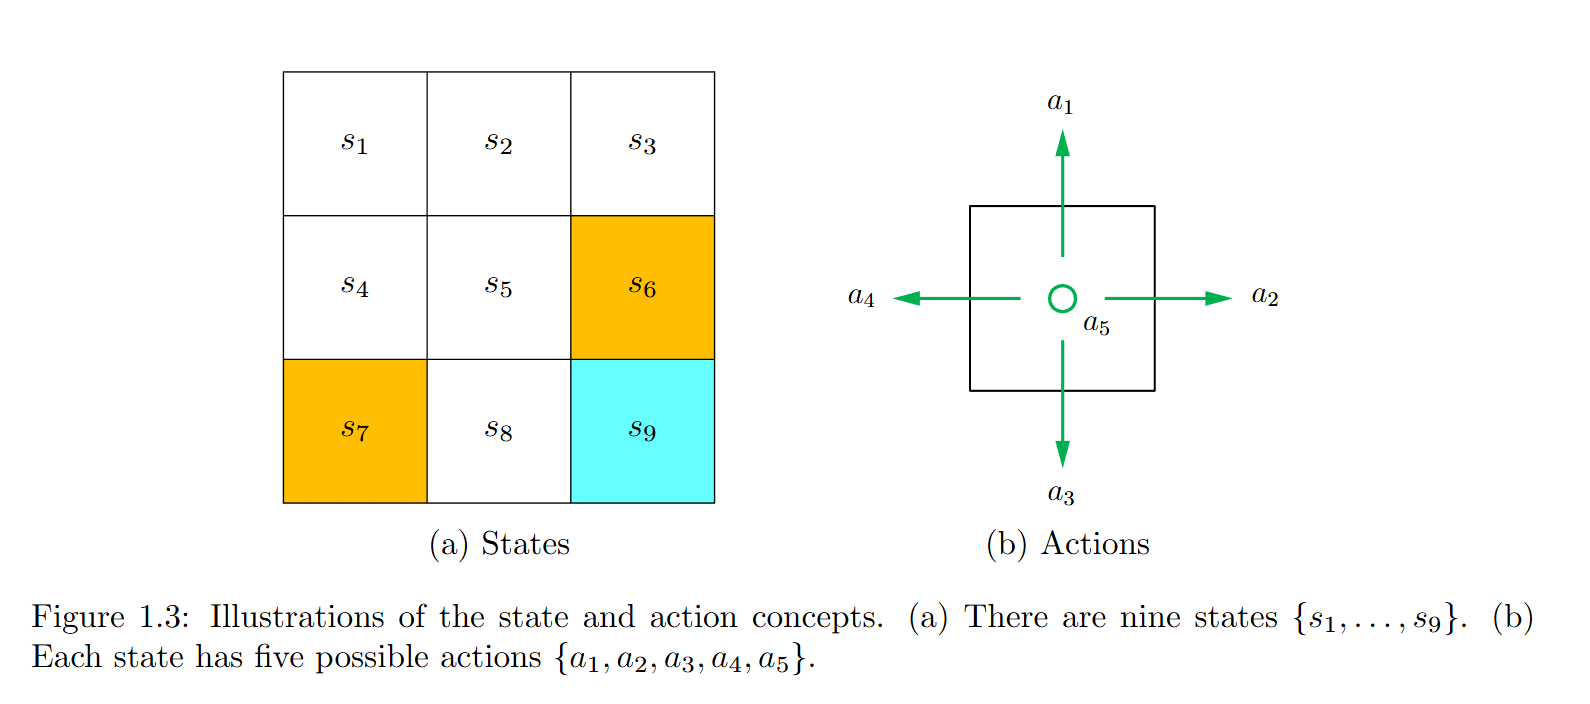
抽象的来说, Agent会在环境中处于不同的”位置”, 我们可以认为总存在一个环境的有限划分, 然后每一个划分中的元素就是一个State(状态)
所有的State合起来就是集合, 比如说在这里9个位置的
动作集合指的是Agent能干的事情, 比如说可以上下左右的移动, 或者原地不动, 把这五个动作编号一下就得到
注意这里的notation, 显然动作是状态的映射, 在不同的状态上能做的动作是不同的, 比如在这个case下Agent在最下面一行他就不能再往下走了, 又比如说
状态之间的变换#
显然在一个状态下如果做出一个动作, 状态会改变(当然也有可能维持原有的状态, 比如动作是原地不动)
如果动作和状态的变化是确定的, 即对于任意的状态a执行任意的(动作空间里面的)动作b后状态变为c, 那么非常容易的可以画出以下的变化矩阵:
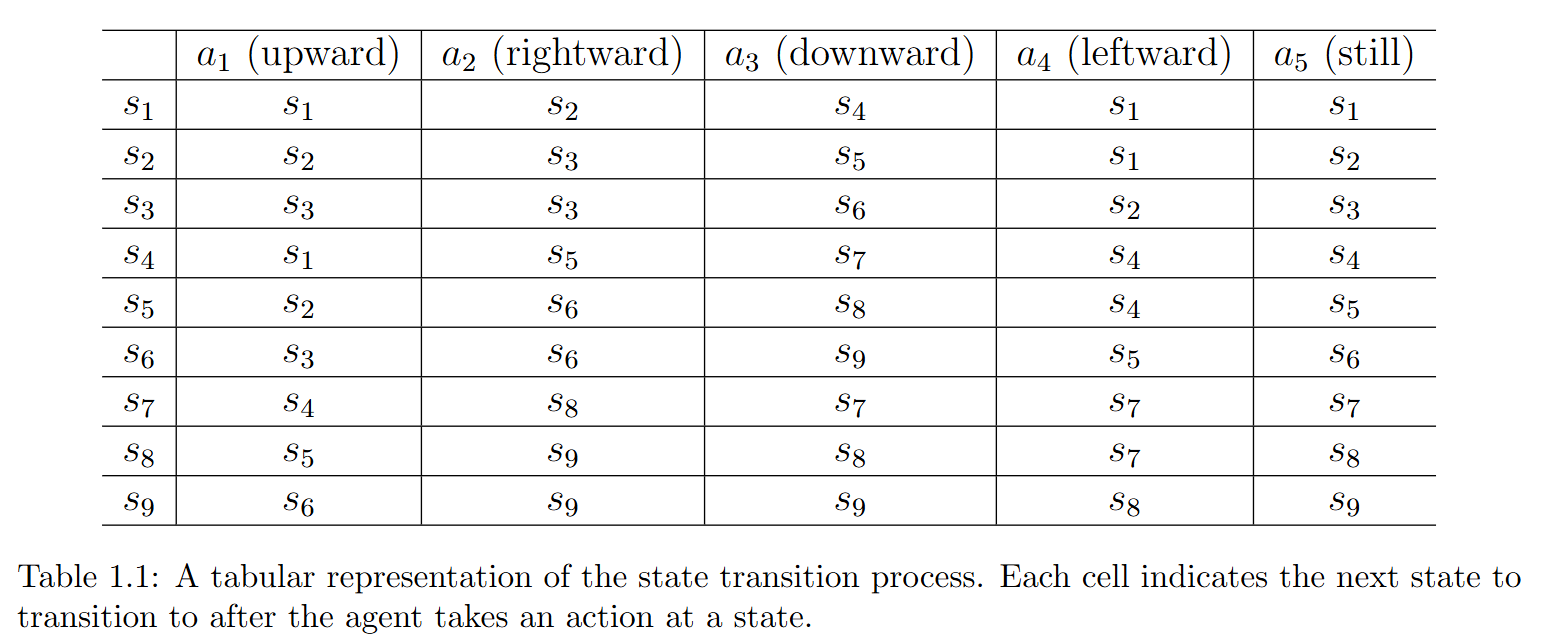
可惜不是所有的状态/动作变换都是确定的, 有这么一种可能, 在状态a执行动作b后有p的概率状态变为c, 1-p的概率状态变为d, 在RL中我们用以下的notation
这个notation给人感觉不是那么的直观, 所以要牢牢地记住
策略(Policy)#
策略就是一个状态的函数, 给定一个状态s, 策略会给出在这个状态下应该采取的动作a, 即, 或者至少给出采取动作a的概率
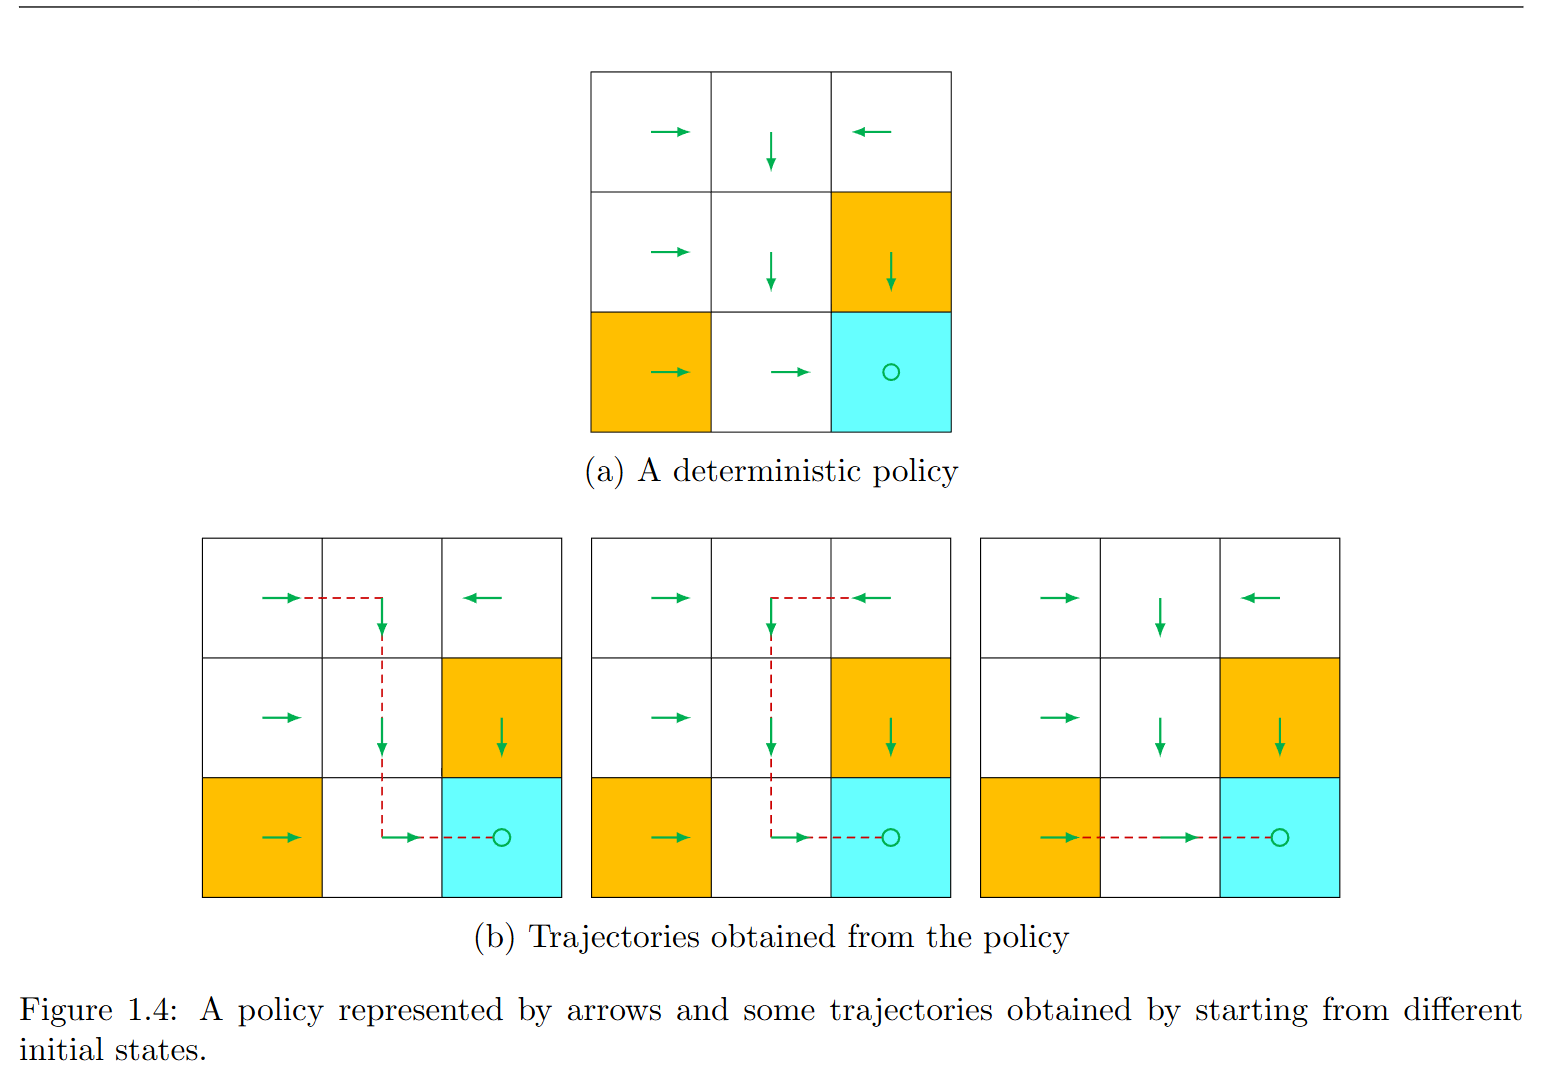
上图是一个确定性的策略, 非常直观, 当我们知道我们现在在哪个格子的时候, 策略就告诉我们下一步往哪里走
一个随机的策略如下图所示, 和状态那里一样, 同样用条件概率来表示采取各个动作的概率
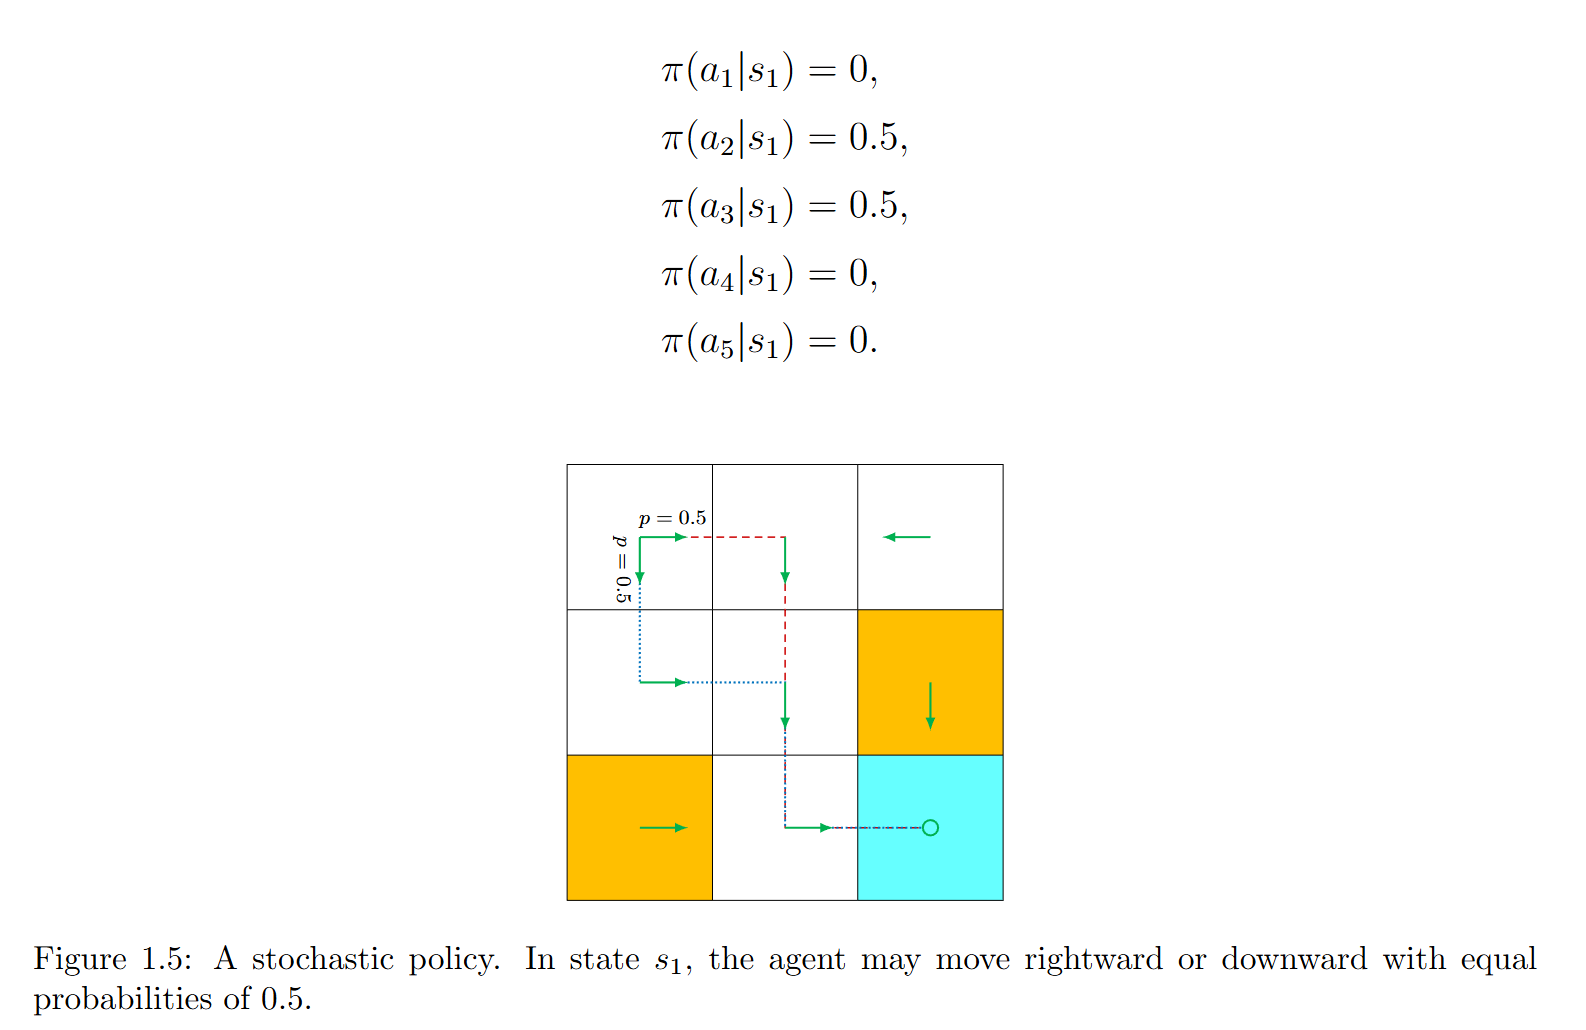
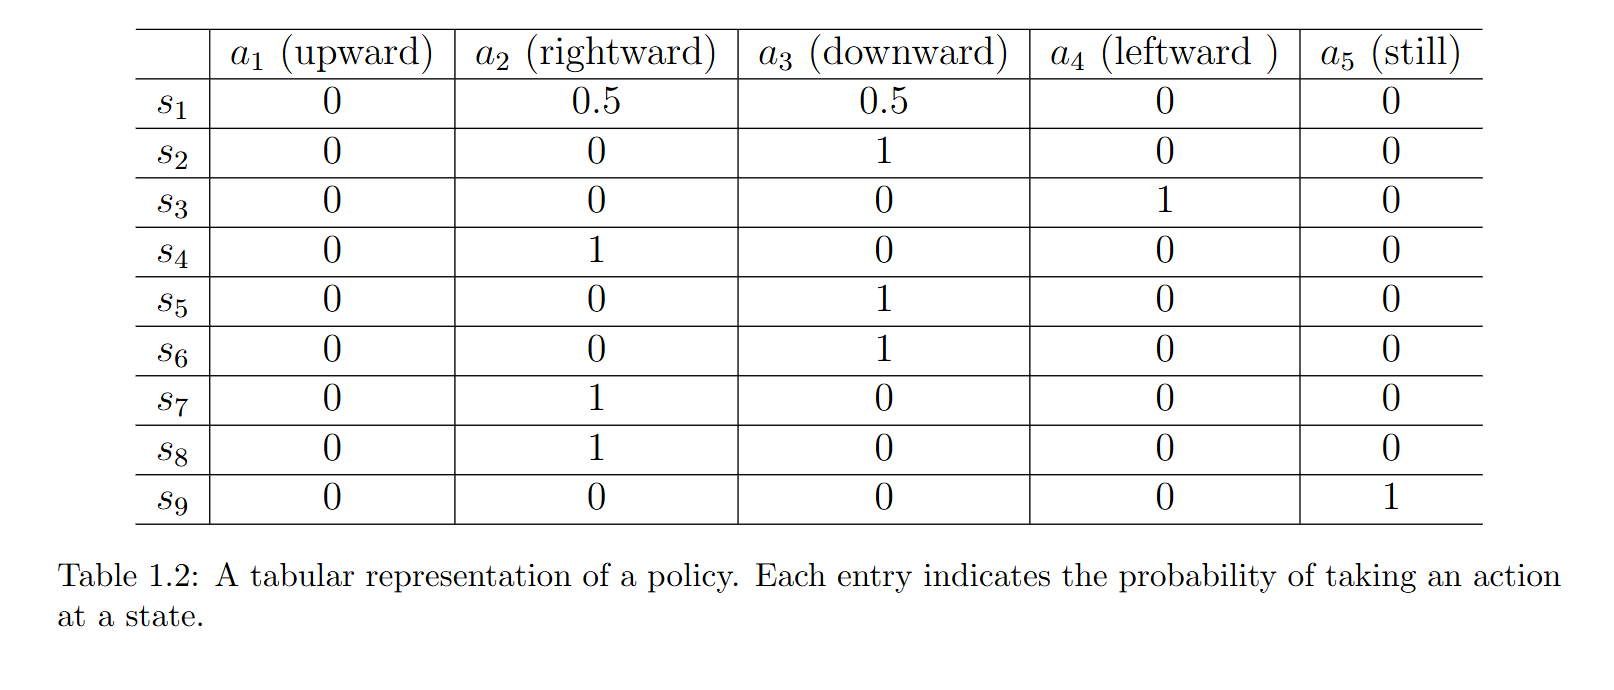
实际上就是说, 在位于左上角那个格子的状态的时候, 两种可能的动作各占一半可能, 在这个机器人爬格子的例子下, 因为我们对所有的状态统一了动作空间(上下左右和不动), 所以可以用一个二位矩阵来表示每个状态下可能的动作和他的概率
奖励(Reward)#
奖励是人为设计的一个, 对已执行的动作产生反馈的函数, 他是用来评估Agent在某个状态下做出的某个动作的好坏的
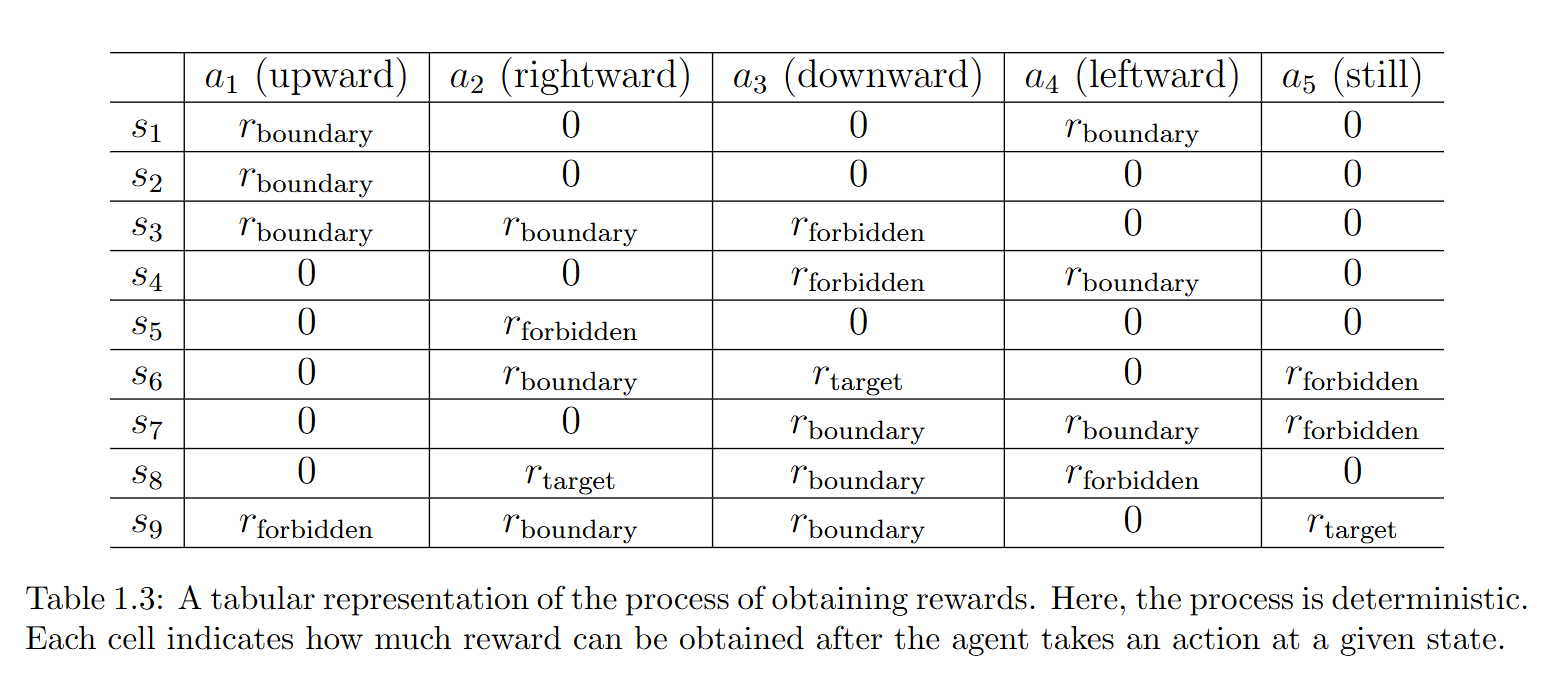
在例子里面可以随便设计符合逻辑的奖励, 比如说在边界状态下试图跨越边界, 给-1作为消极奖励, 如果从某个状态走到了Target, 给1作为积极奖励
同样的, 我们用条件概率去表示奖励, 比如说我想表达在在状态a执行动作b后得到奖励r, 可以写成:
同样的可以画出矩阵, 来表达在状态s下执行动作a得到什么奖励
轨迹(Trajectory)#
轨迹是一个(状态, 动作, 奖励)的序列, 用自然语言描述就是:
在状态执行动作并且获得奖励,其中i是轨迹的每一步的index
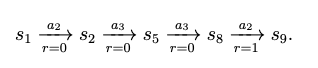
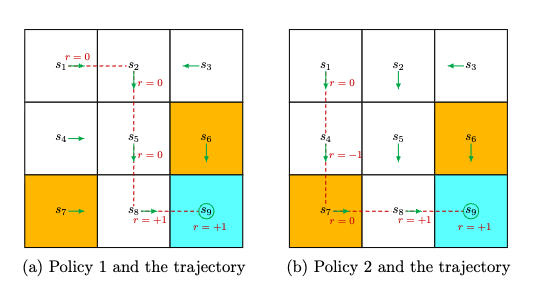
对于一个确定性的策略, 即
给定一个起始的状态, 轨迹就是确定的了
回报(Return)#
回报指的是沿着一条轨迹从头到尾走完, 把每一步的Reward求和得到的最后数值, 一般来说用回报来衡量一个策略的好坏
有个数学问题是, 如果轨迹无限长, 有可能部分和是发散的, 为了确保回报收敛需要引入一个折价因子, 例如
这个数项级数显然是绝对收敛的, 因为只要取
那么
证明完毕
马尔可夫决策过程(Markov decision processes)#
一个马尔可夫决策过程(MDP)是上面这些概念的大杂烩:
状态空间: $\mathcal{S}$
动作空间: $\mathcal{A}(s), 是某个状态的函数$
奖励集合: $\mathcal{R}(s,a), 是某个状态和动作的函数$除此之外还有两个模型(用条件概率表示):
第一个条件概率度量在状态s执行动作a后变化到其他状态s’的概率, 显然有以下概率之和的恒等式成立:
第二个条件概率度量在状态s执行动作a后获得奖励r的概率, 显然有以下概率之和的恒等式成立:
MDP还具备一种性质,即当前状态只和前一个状态以及前一个动作有关, 而和更早的状态和动作无关, 即:
注意一个事实, 在RL中模型即概率(条件概率), 所以以上两个条件概率
其实就是模型本身
马尔可夫过程(Markov Process)#
当MDP里面的策略被固定后, 就退化成一个马尔可夫过程(MP), 此时所有的状态转移概率和奖励-动作概率都已经确定, 下面这个图是一个例子:
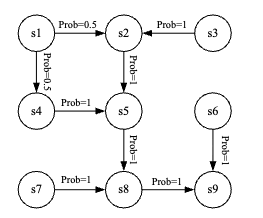
图中状态之间的转移概率已经确定, 因为策略已经确定了, 所以每个状态上做动作的分布也确定了, 即一切的概率都确定了