RL Course Notes (Part 3)#
最优状态值和贝尔曼最优方程#
上次讲了状态值和动作值的计算方式:
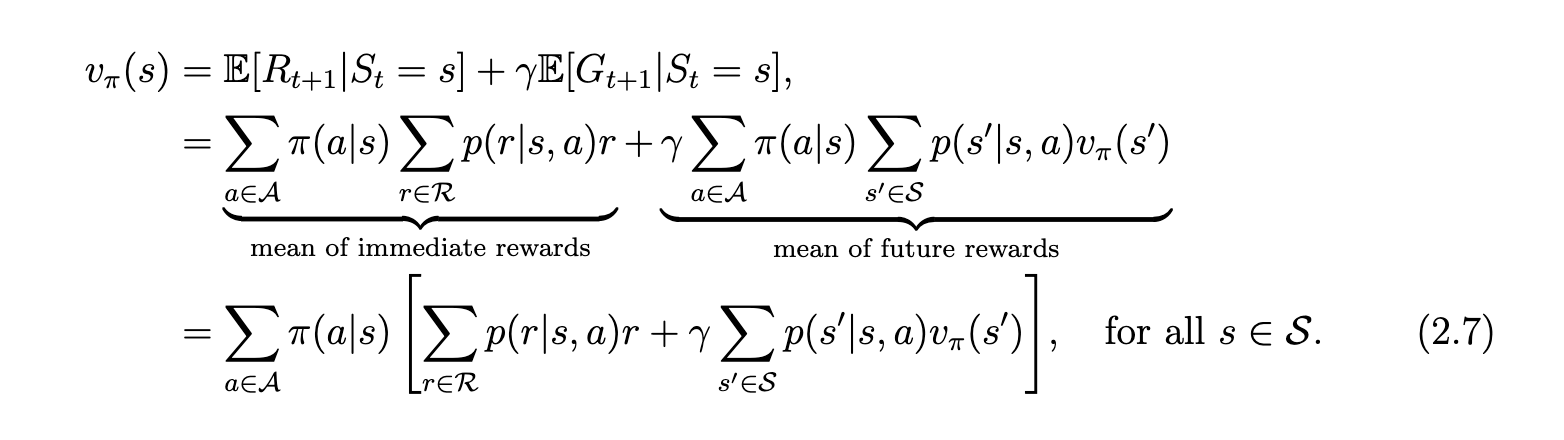
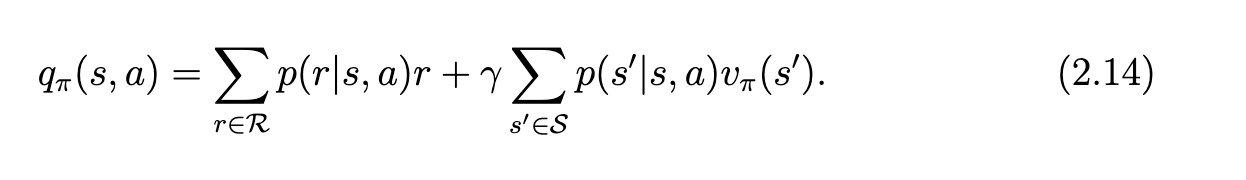
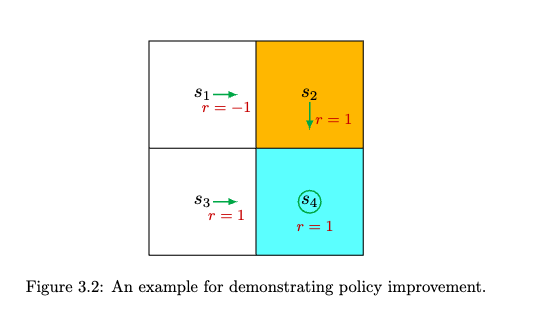
通过一个简单的例子来算一算, 只要注意状态值是自迭代的, 动作值是依赖于状态值的即可
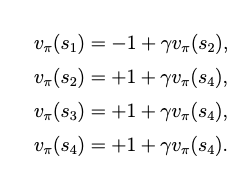
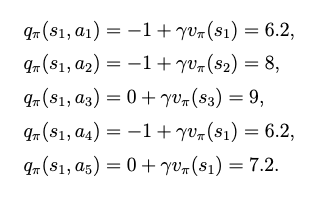
直观上可以这么理解, 对于状态值, 我从现在这个状态出发, 首先有第一个概率决定我下一步走到哪个状态, 这是第一层期望。 当我走到这众多状态的某一个后, 我又有一个概率会获得许多不同的reward, 这是第二层期望的第一部分。 同时我还有从这个状态出发再走到下一个状态, 所以这是第二层期望的第二部分。
对于动作值, 由于目前所做的动作是确定的了, 所以就没有第一层期望了, 但是注意到就算动作确定了, reward仍然是一个分布, 再下次走到的状态也是一个分布, 所以仍然是有一层期望的两部分。
最优状态值和最优策略#
不管你用什么策略, 状态是已经被环境确定了的, 所以可以通过每个状态的状态值来衡量策略的好坏, 若满足下列条件:
那么就说策略比策略要好, 反之亦然。如果存在一个策略使得他比其他所有策略好, 那么就说这个策略是最优策略。
对于这个最优策略, 把他的状态值(这是一个集合, 因为有很多状态)叫做最优状态值
书上给了关于最优策略的四个问题, 分别是:
- 是否存在
- 是否唯一
- 是确定性策略还是随机策略
- 有没有一个算法去找到最优策略
贝尔曼最优方程#
根据之前的贝尔曼最优方程,最大化右侧得到:
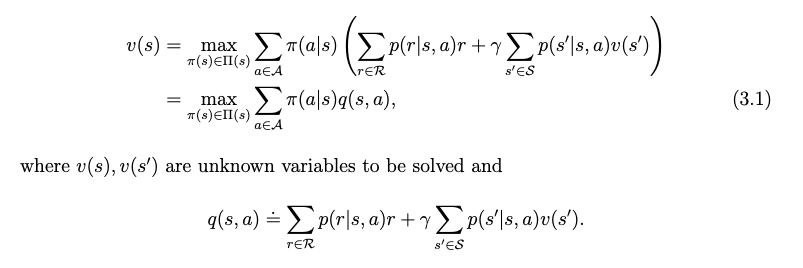
这是贝尔曼最优方程, 注意他不是一个恒等式, 还是一个关于和的方程, 所以以上的四个问题都变成了解这个方程的问题
多元约束条件#
书上给了一个多元数量函数的例子
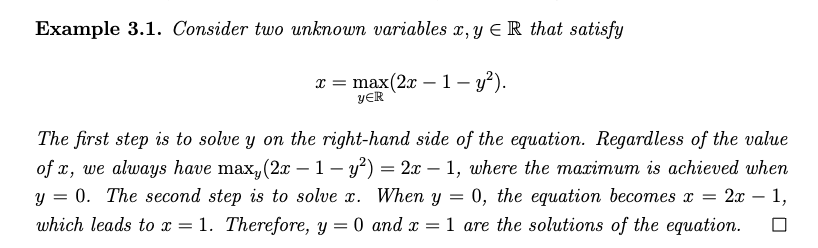
这个例子非常平凡, 首先你要让右边在这个的条件下达到最大, 这个条件和x无关, 所以根据二次函数性质当然应该取, 从而x=1
回到这个最优方程上来, 同样的我们也需要先找一个使得右边达到最大, 然后再来解这个方程, 看书上给的第二个初等例子:
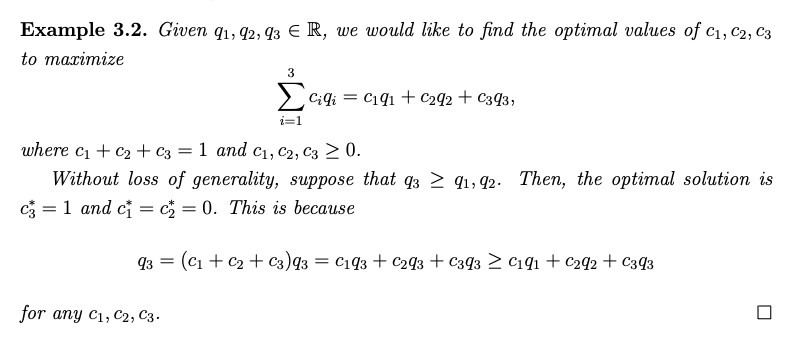
题目给了一个比较trick的做法, 当然这里是个连续场景下的条件极值问题, 如果用Lagrange乘数法也可以得到一样的答案。
这个问题本质上和我们的贝尔曼最优方程也是一样的, 因为所有的求和为1, 所以: