项目说明#
本项目是我在HKU MMLab实习期间, 由Dr. Xinyu Pan和Prof.Bo Dai指导的Agent Memory的科研项目的研究与实验记录, 在此之前 我们已经做了大概4个月(From April 2026), 所以我会先写一些之前的设计和问题, 以及工程经验, 然后到了后面应该每次写的就都是 最新的问题和研究成果了,对于踩坑了的地方,也许都会专门开一篇来写
文档说明#
本文档概述训练的全流程,
研究问题#
通俗的来说, 现在业界用的memory有两个问题:
- 结构过于平坦, 类似数据库, 不能很好的反应记忆元素之间的上下级关系
- 在调整记忆之间的关系的时候, 总是以来agent自身去调整, 成本高+时间慢
解决办法#
我们针对这两个问题各自提出一个办法,
- 提出一个叫做membrain的树记忆结构, 每个记忆就算做是树的一个节点, 这样天然提供上下级和其他的语义关系
- 用一个小模型结合自己设计的动作空间来决策如何调整记忆结构
理想的话, 这应该可以大幅度降低开销
研究中的数据结构#
Membrain#
Membrain是一个记忆系统, 其中每个元素是一棵树,根代表记忆归属的主体, 比如说所有和电脑相关的记忆都归属于电脑这个根节点
Aspect节点代表一种子类,比如笔记本电脑就是电脑根节点的一个子类
Fact代表事实/记忆本身,比如说笔记本电脑在xxxx年被发明,这就是一个记忆
简单理解就是一个N叉树,上下级关系表示语义
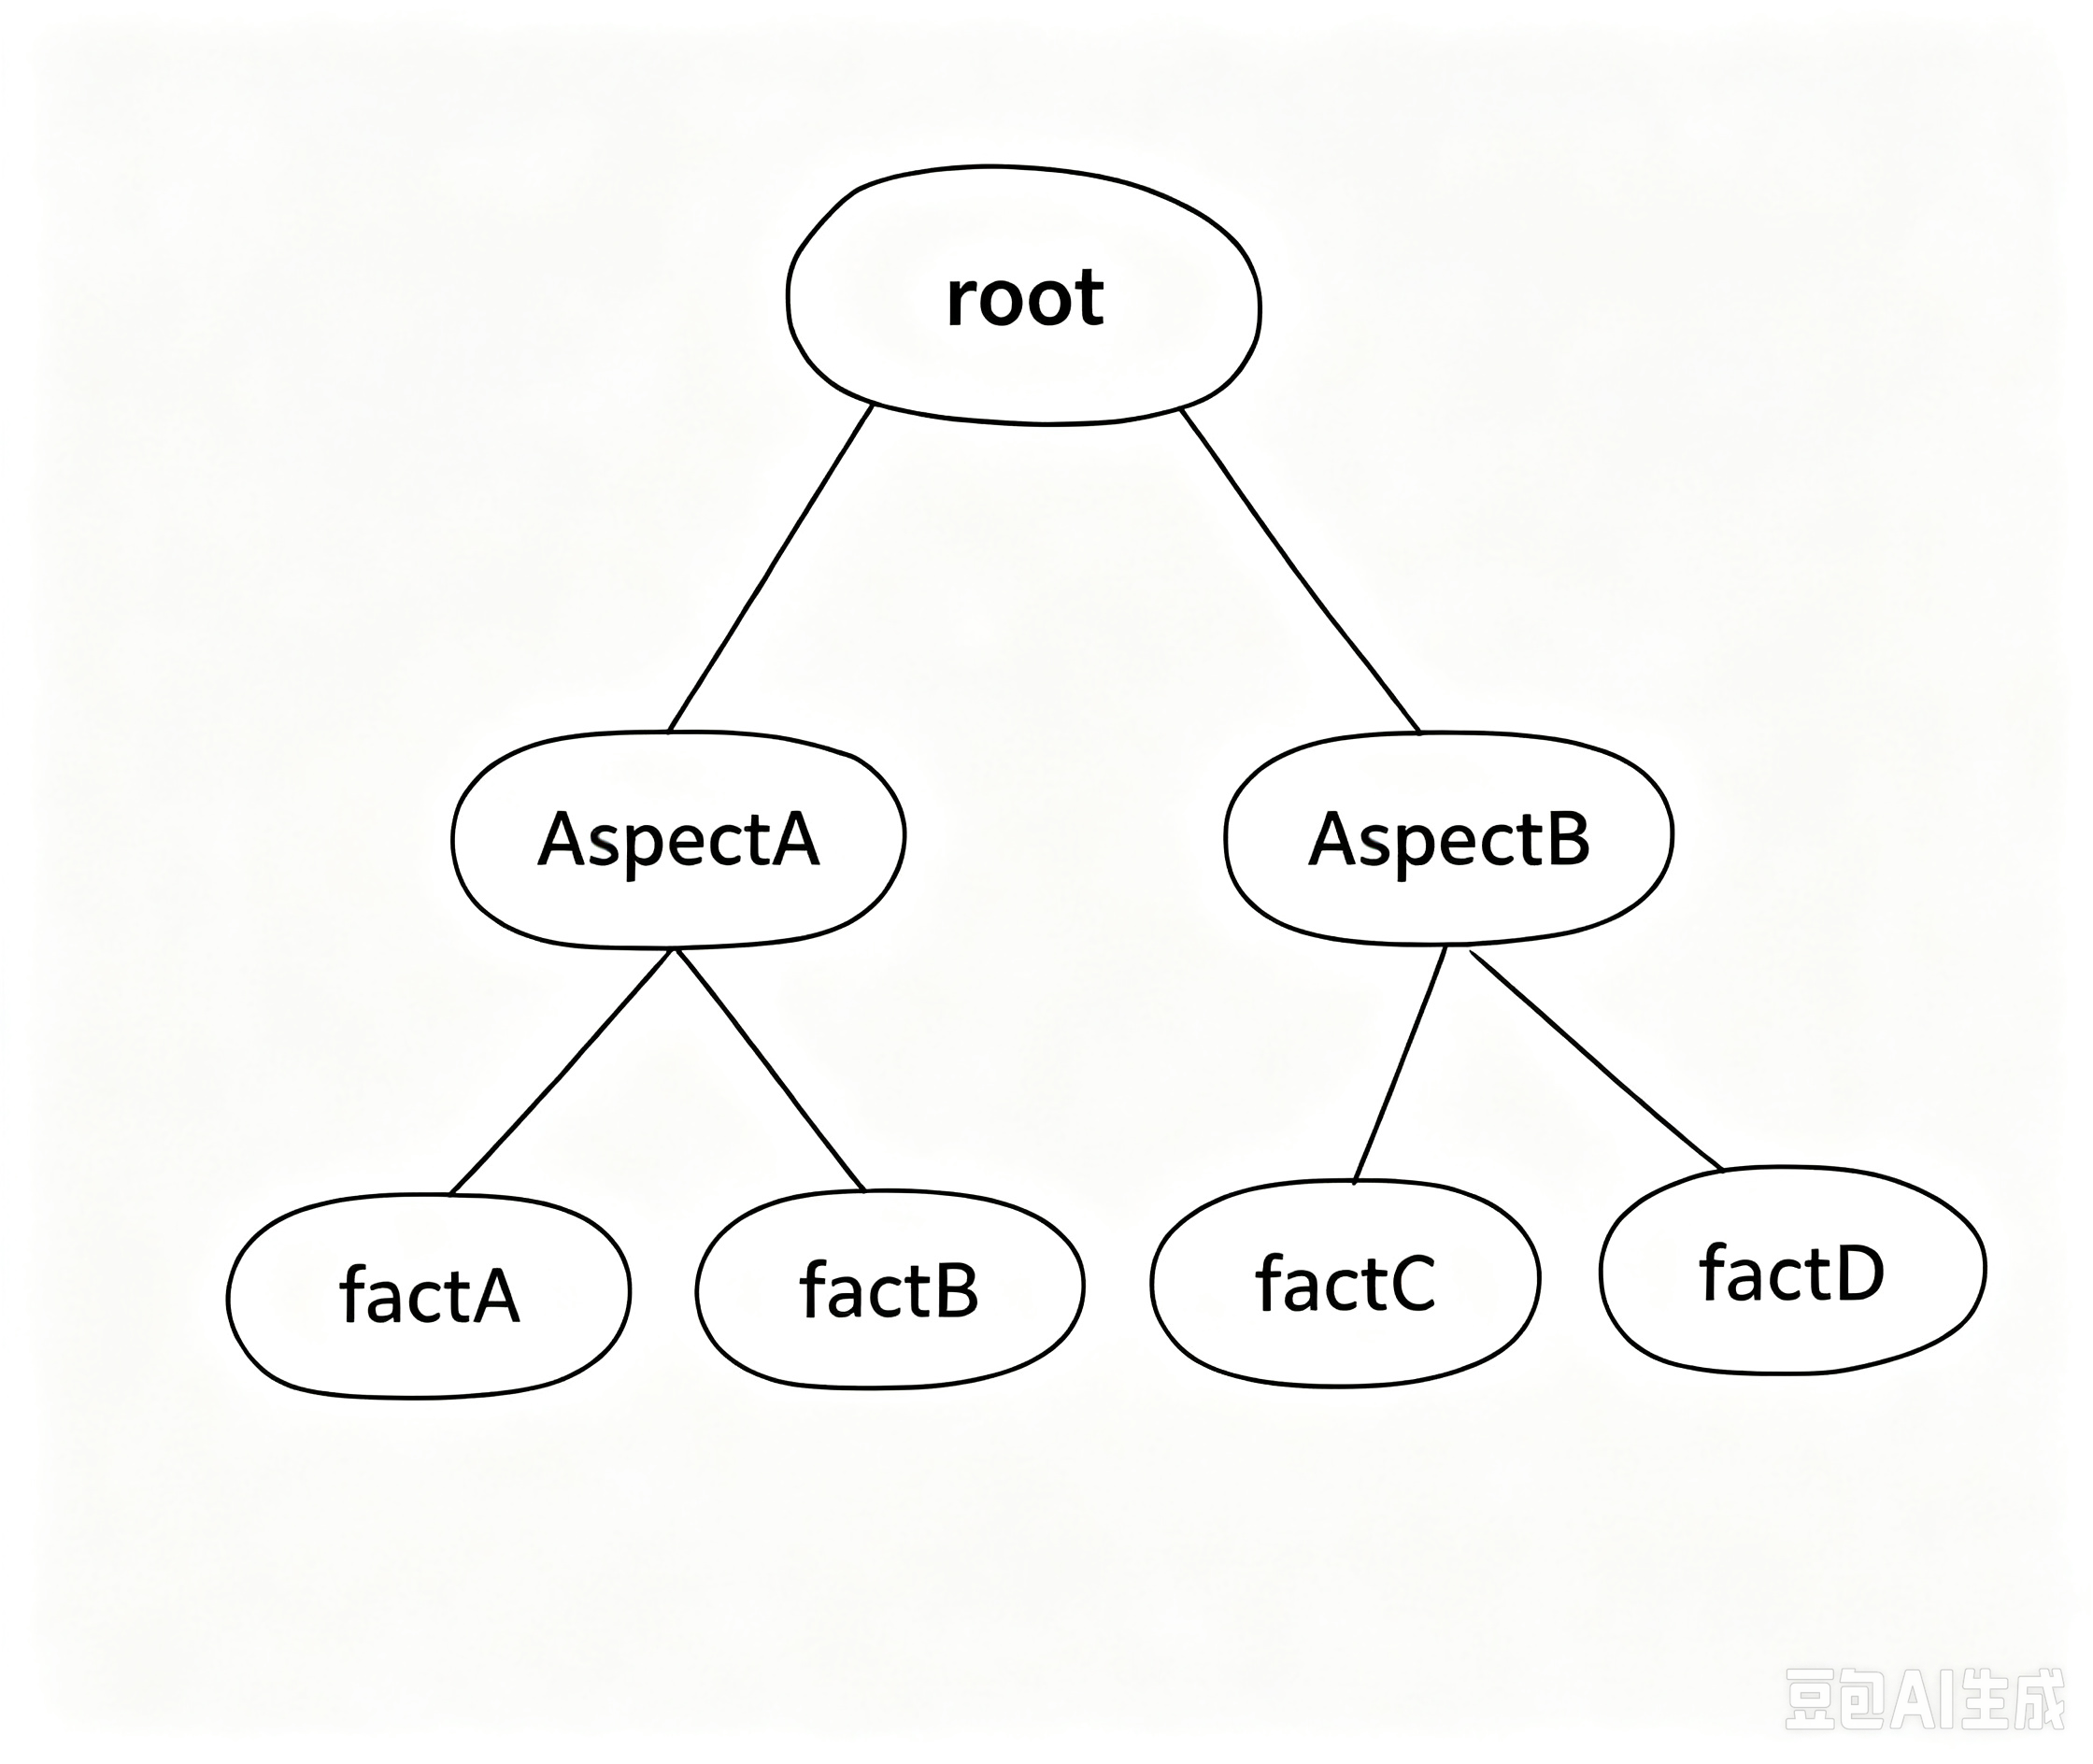
一颗完整的树可能很宽很深,因为语义可以大分叉
闭包#
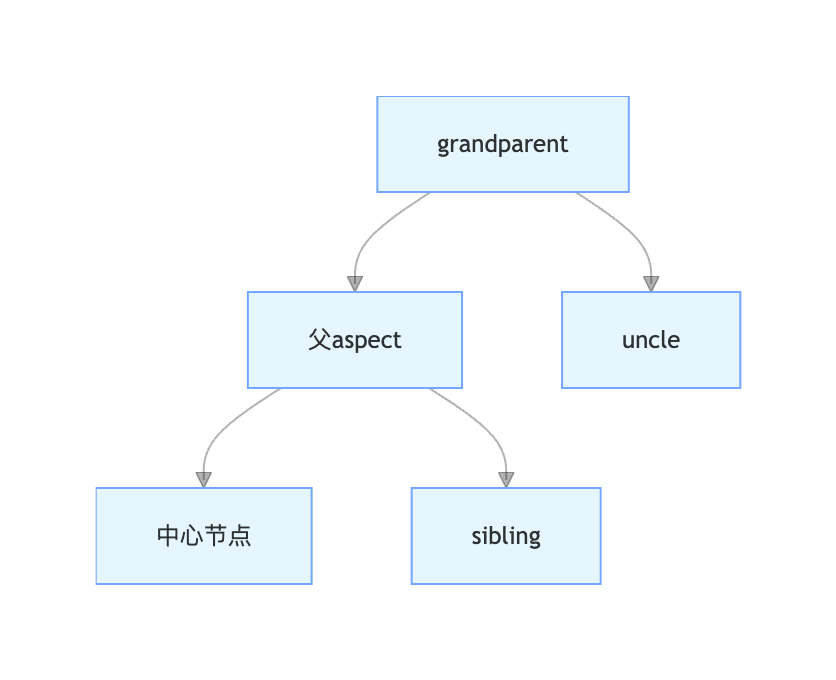
闭包是一个专有名词,他必须由一个fact节点生成,规定他包含fact自己,兄弟,父亲,父亲的兄弟,以及祖父
当然有可能深度不够,导致没有祖父,那就是父亲和兄弟
这是我们定义的一个重要数据结构,以后的操作都在这上面做
两层子树#
用这个专有名词来指代字面意思,某个node和他的所有直接孩子,叫做两层子树
两阶段决策拆分#
一阶段stage1#
假设你有一颗membrain树,现在来了个新节点,需要挂上去,这总可以用这样一个递归算法决策:
cur = root # 从root开始
new_node # 新node
while True:
    subtree = [cur + child for child in cur.children] # 两层子树
    decision_index = stage1_network(new_node, subtree) # 输出决策,必然是cur,或者cur的孩子中的aspect节点
    if subtree[decision_index] == cur: # 如果是决定挂载到cur上
        cur.child.append(new_node)
        return subtree[decision_index] # 决策完毕,挂上去

    else: # 如果是决定挂载到cur的孩子aspect
        cur = subtree[decision_index] # 又从那个孩子aspect重新决策
因为树高有限,每次往下走一步,总是会结束的,所以不会无限循环,到最后一层决策完了就跳出去了
stage1 network#
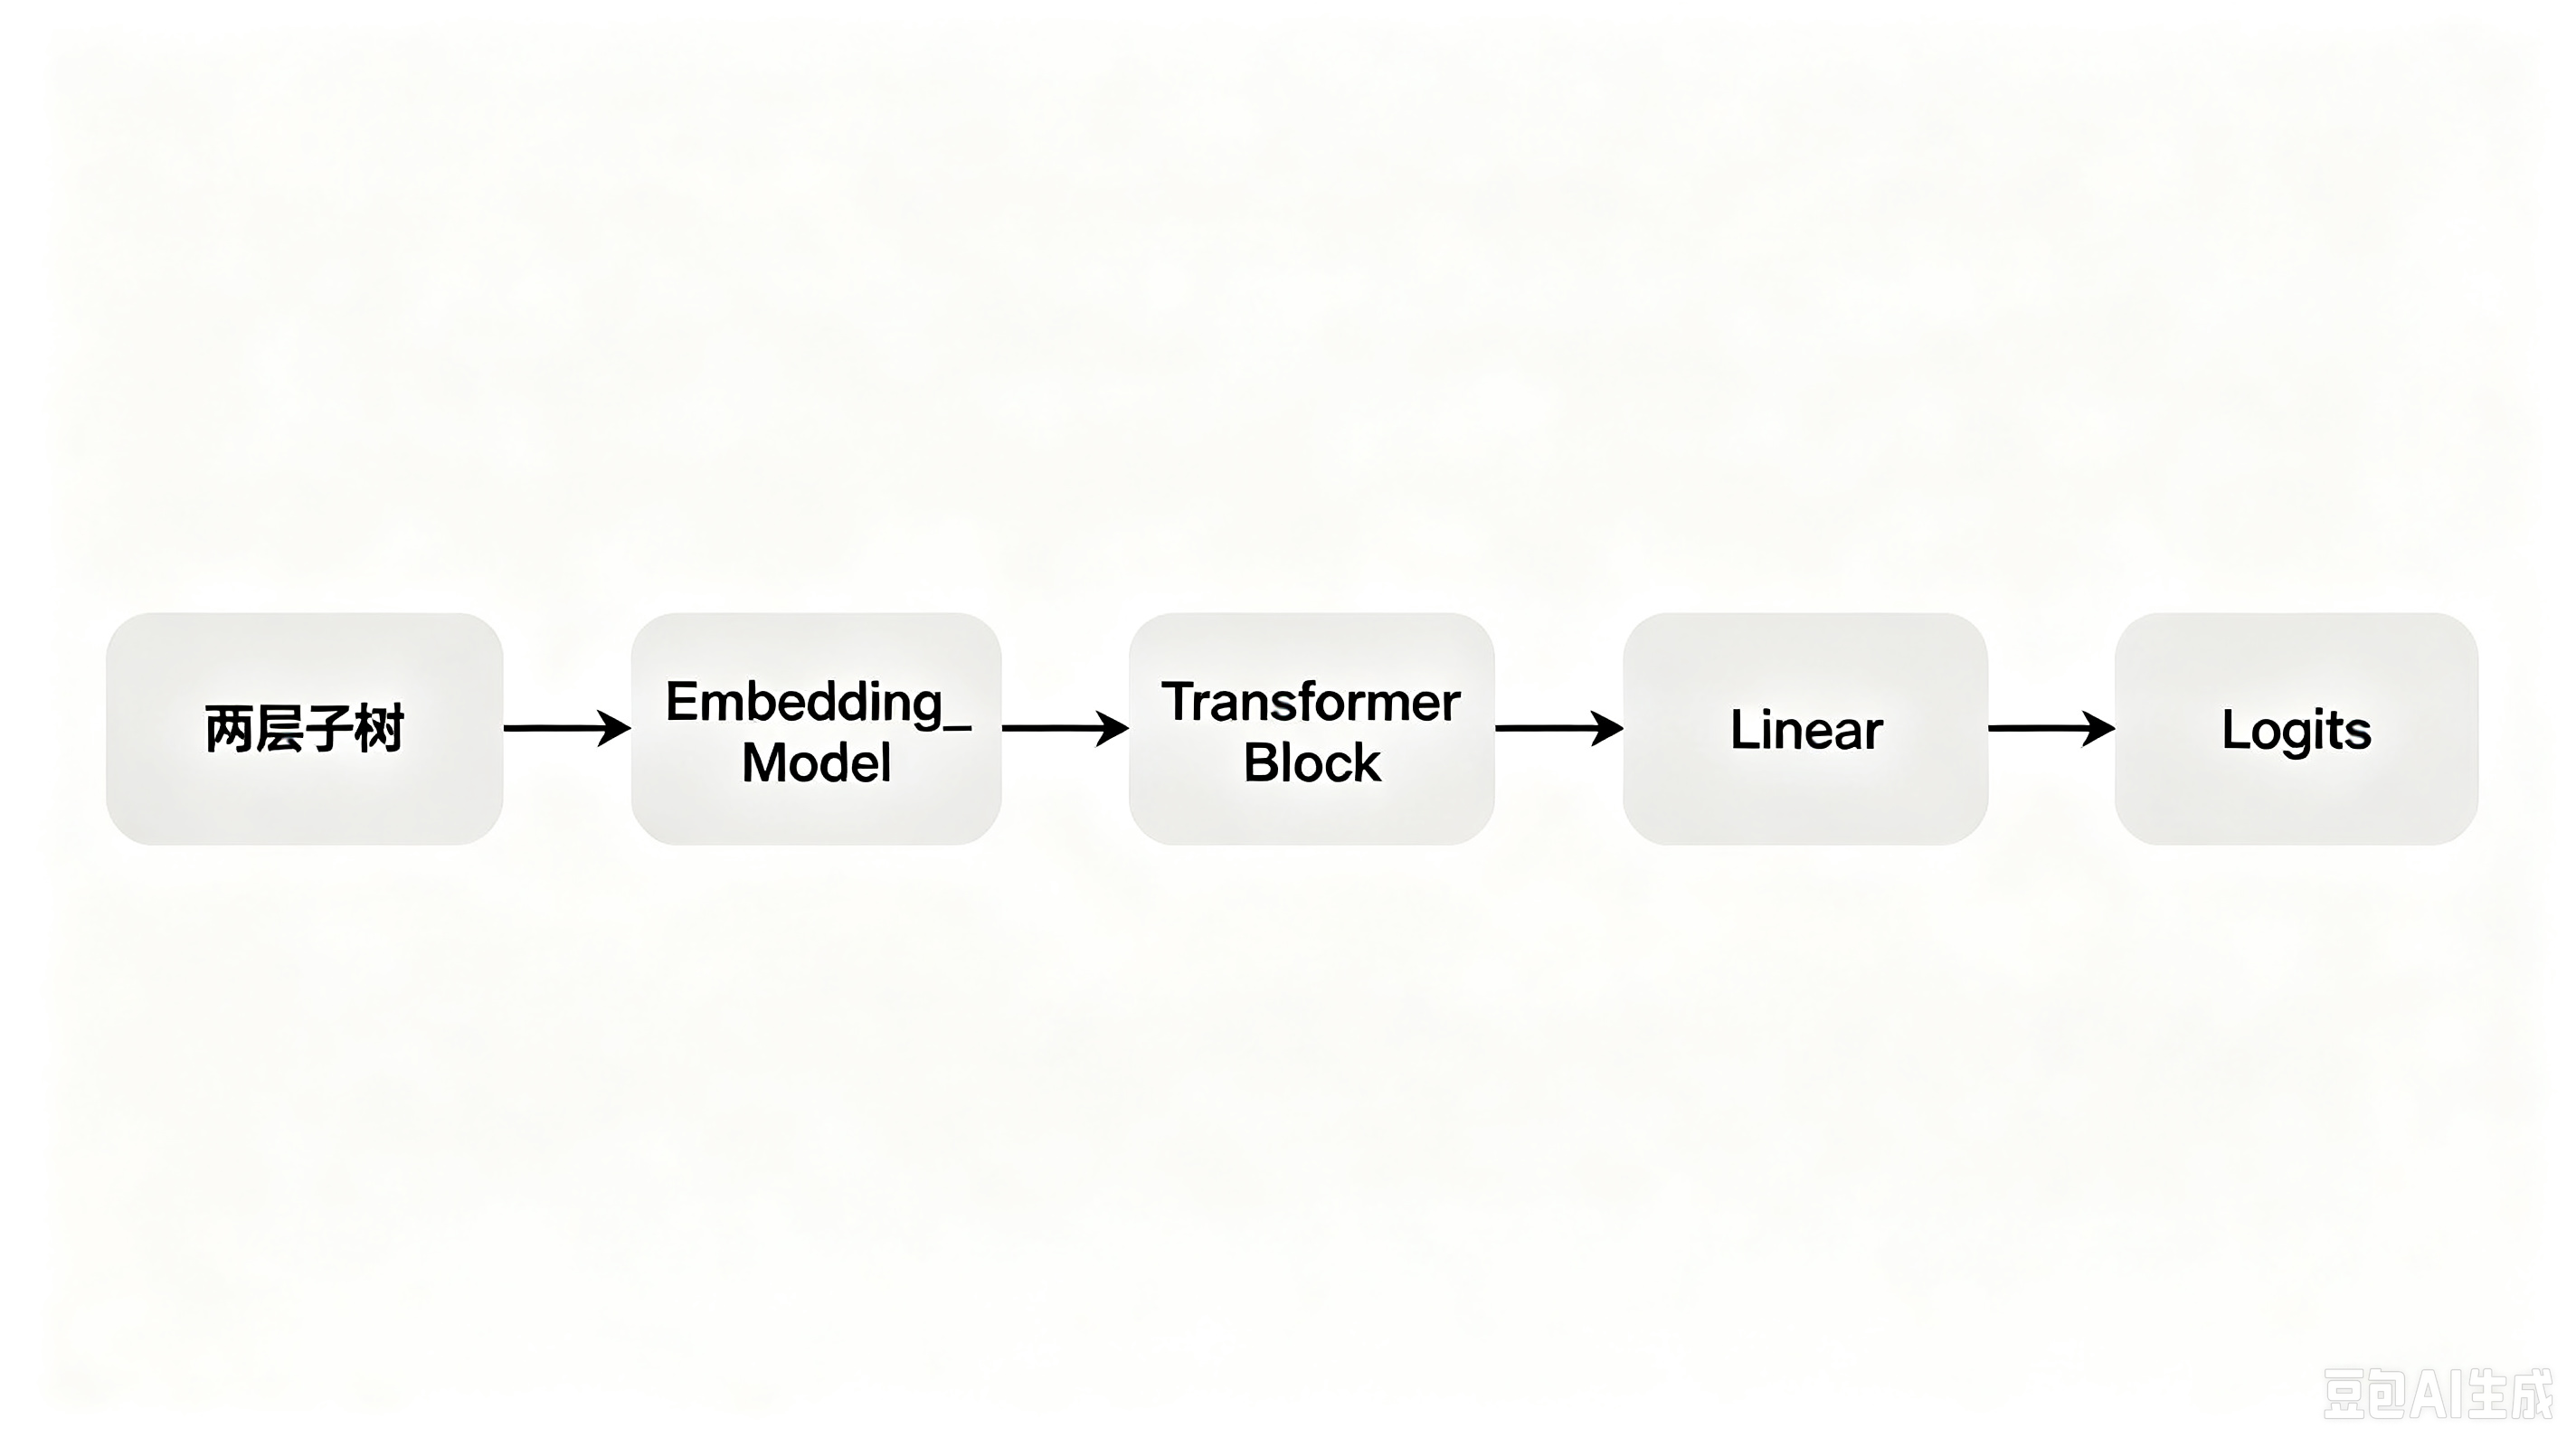
讲简单点,这个网络就负责吃一个二层子树,然后输出一串logits,最后argmax一下把index选出来
可以理解为就是一个transformer_block,然后接一个Linear做成logits
二阶段Stage2#
现在新的fact已经放到tree上了,但我假设这个fact周围的一些node排列还不是很合理,所以我希望另一个网络可以输出一些树的可执行动作 目的就是让附近的node排列变得更合理
closure = build_closure(fact) # 根据这个fact生成closure
Action_Series = stage2_network(closure) # 生成做的动作
tree = apply_action(Action_Series) # 把动作做上去显然这里就没有stage1那么容易了,因为这里的action_space比较复杂,不是选个index就完事了的
二阶段stage2的动作#
- Promote 把一个fact节点提到他的grandparent下
def Promote(fact):
    fact.parent.children.remove(fact)
    fact.parent.parent.children.append(fact)
    fact.parent = fact.parent.parent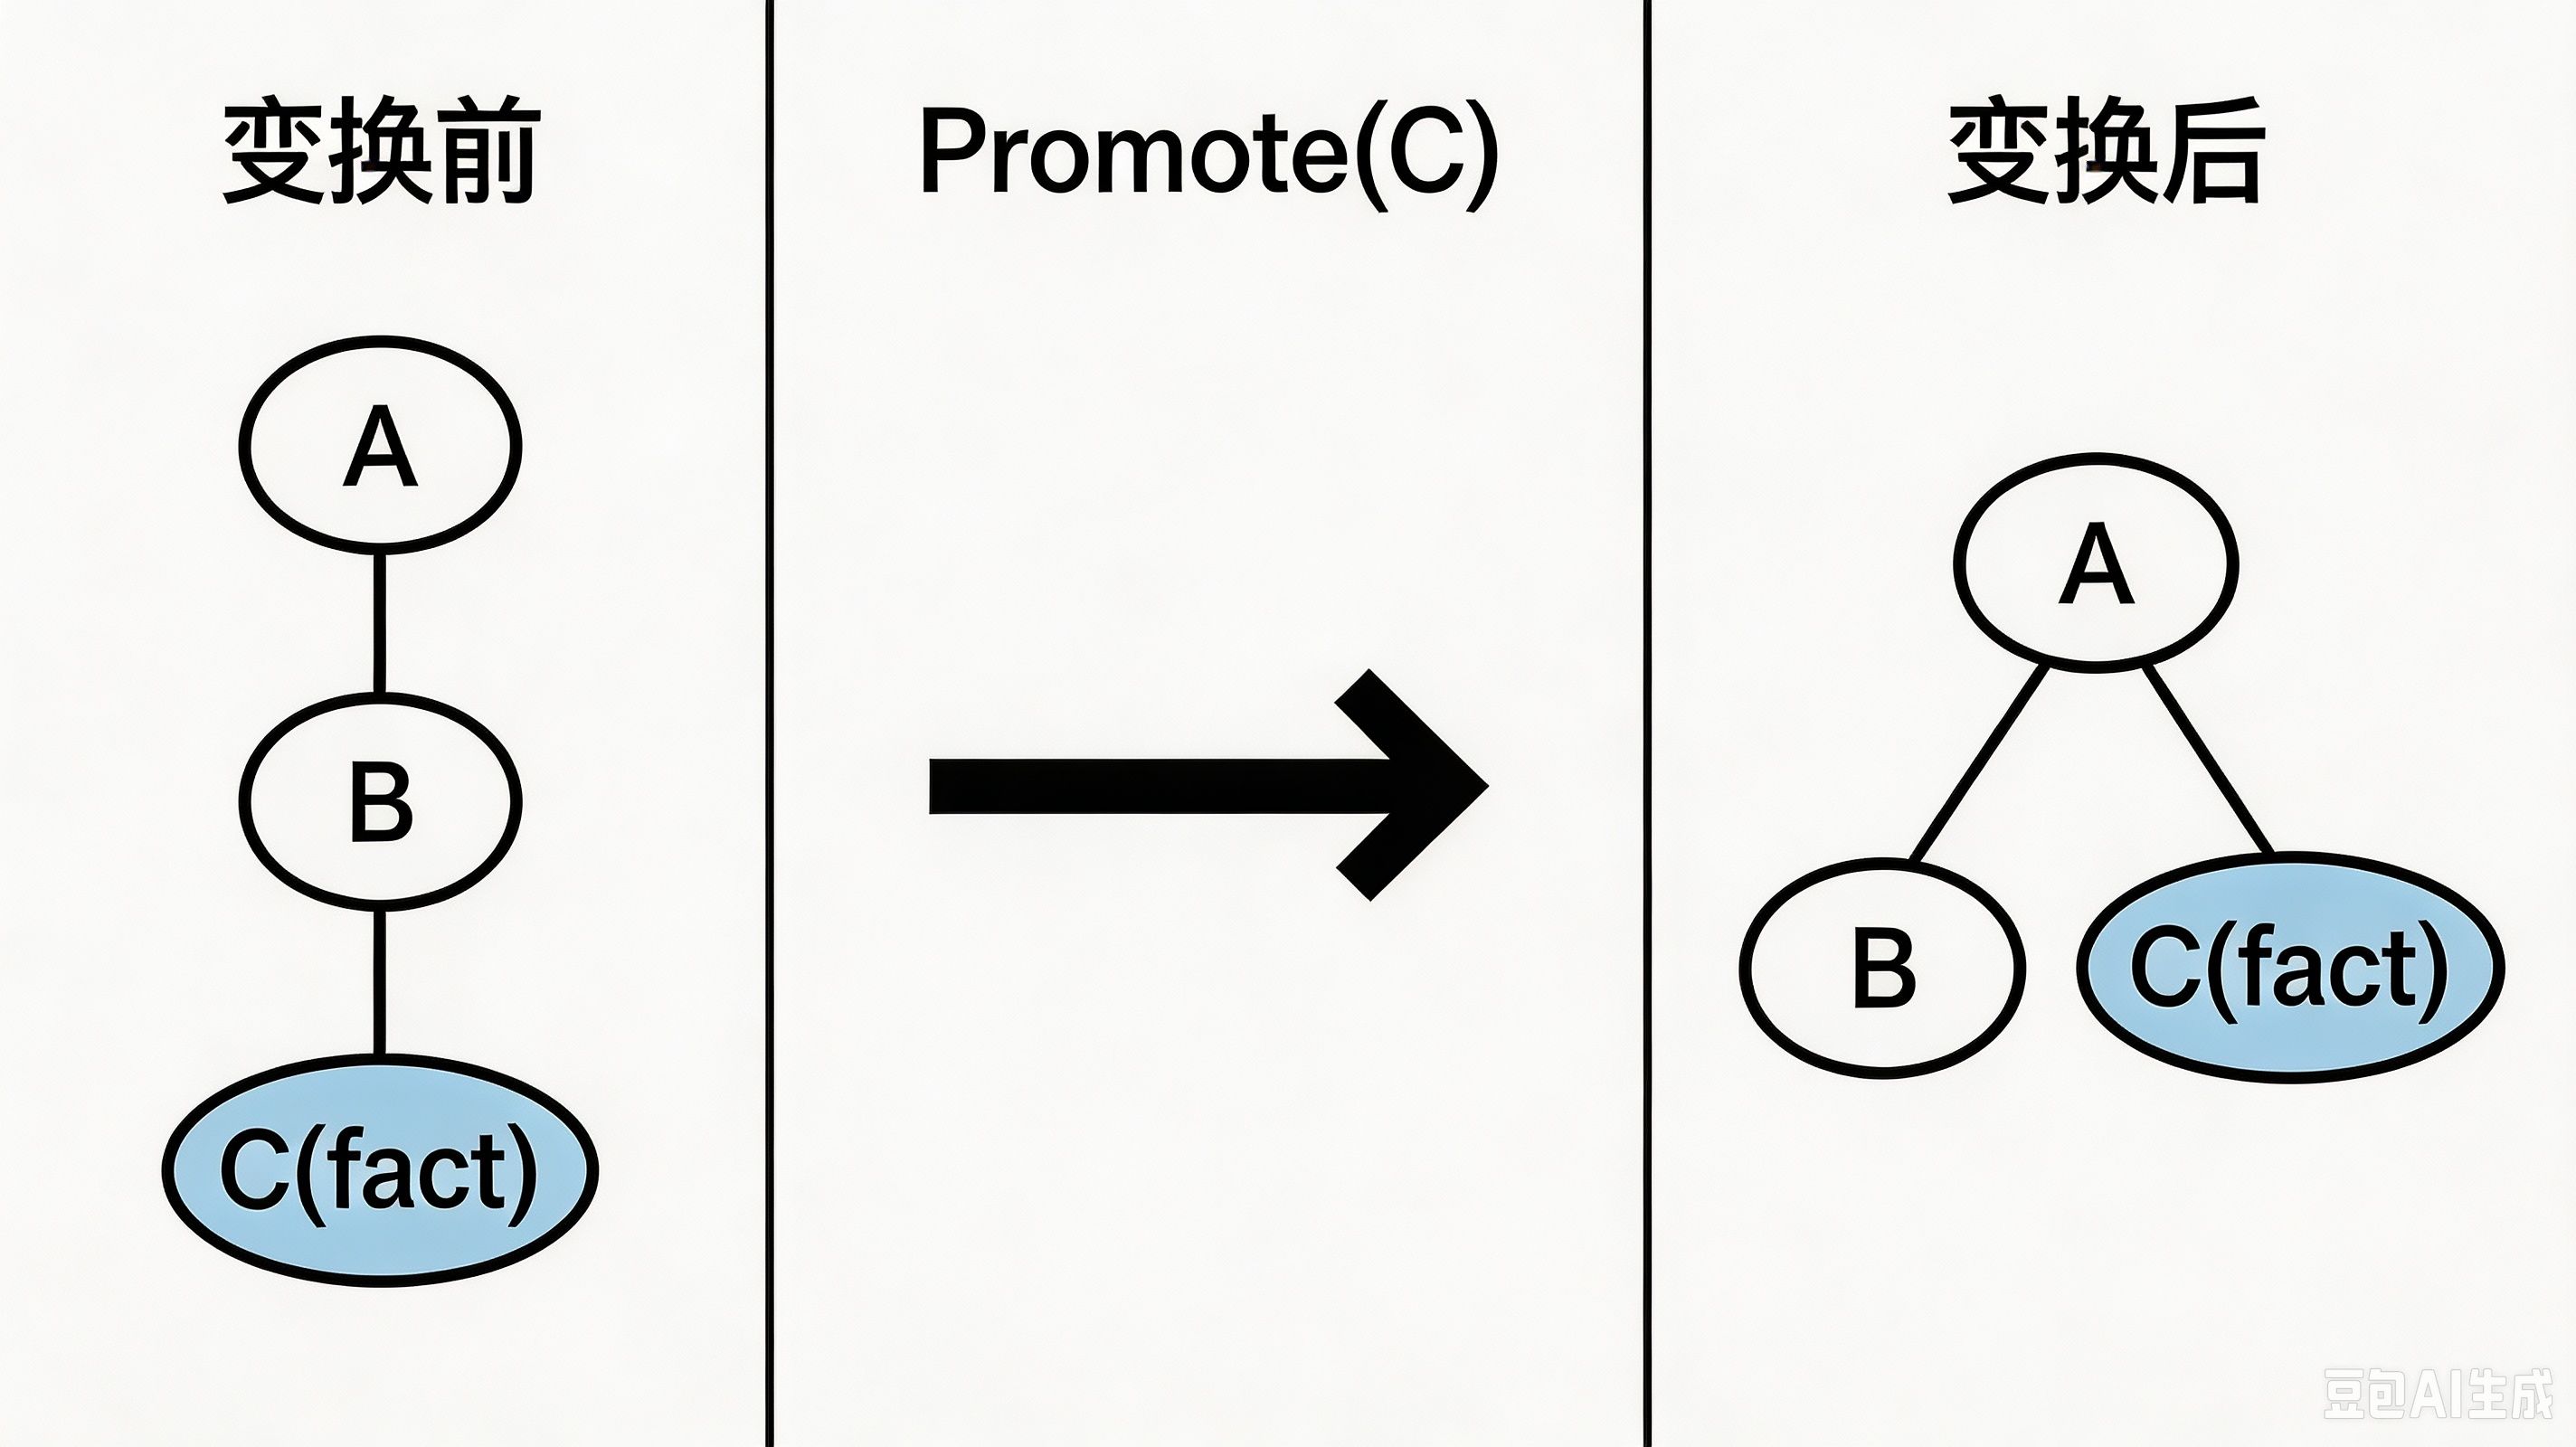
- Demote 把一个fact节点放到他的sibling aspect下
def Demote(fact, sibling_aspect):
    fact.parent.children.remove(fact)
    sibling_aspect.children.append(fact)
    fact.parnet = sibling_aspect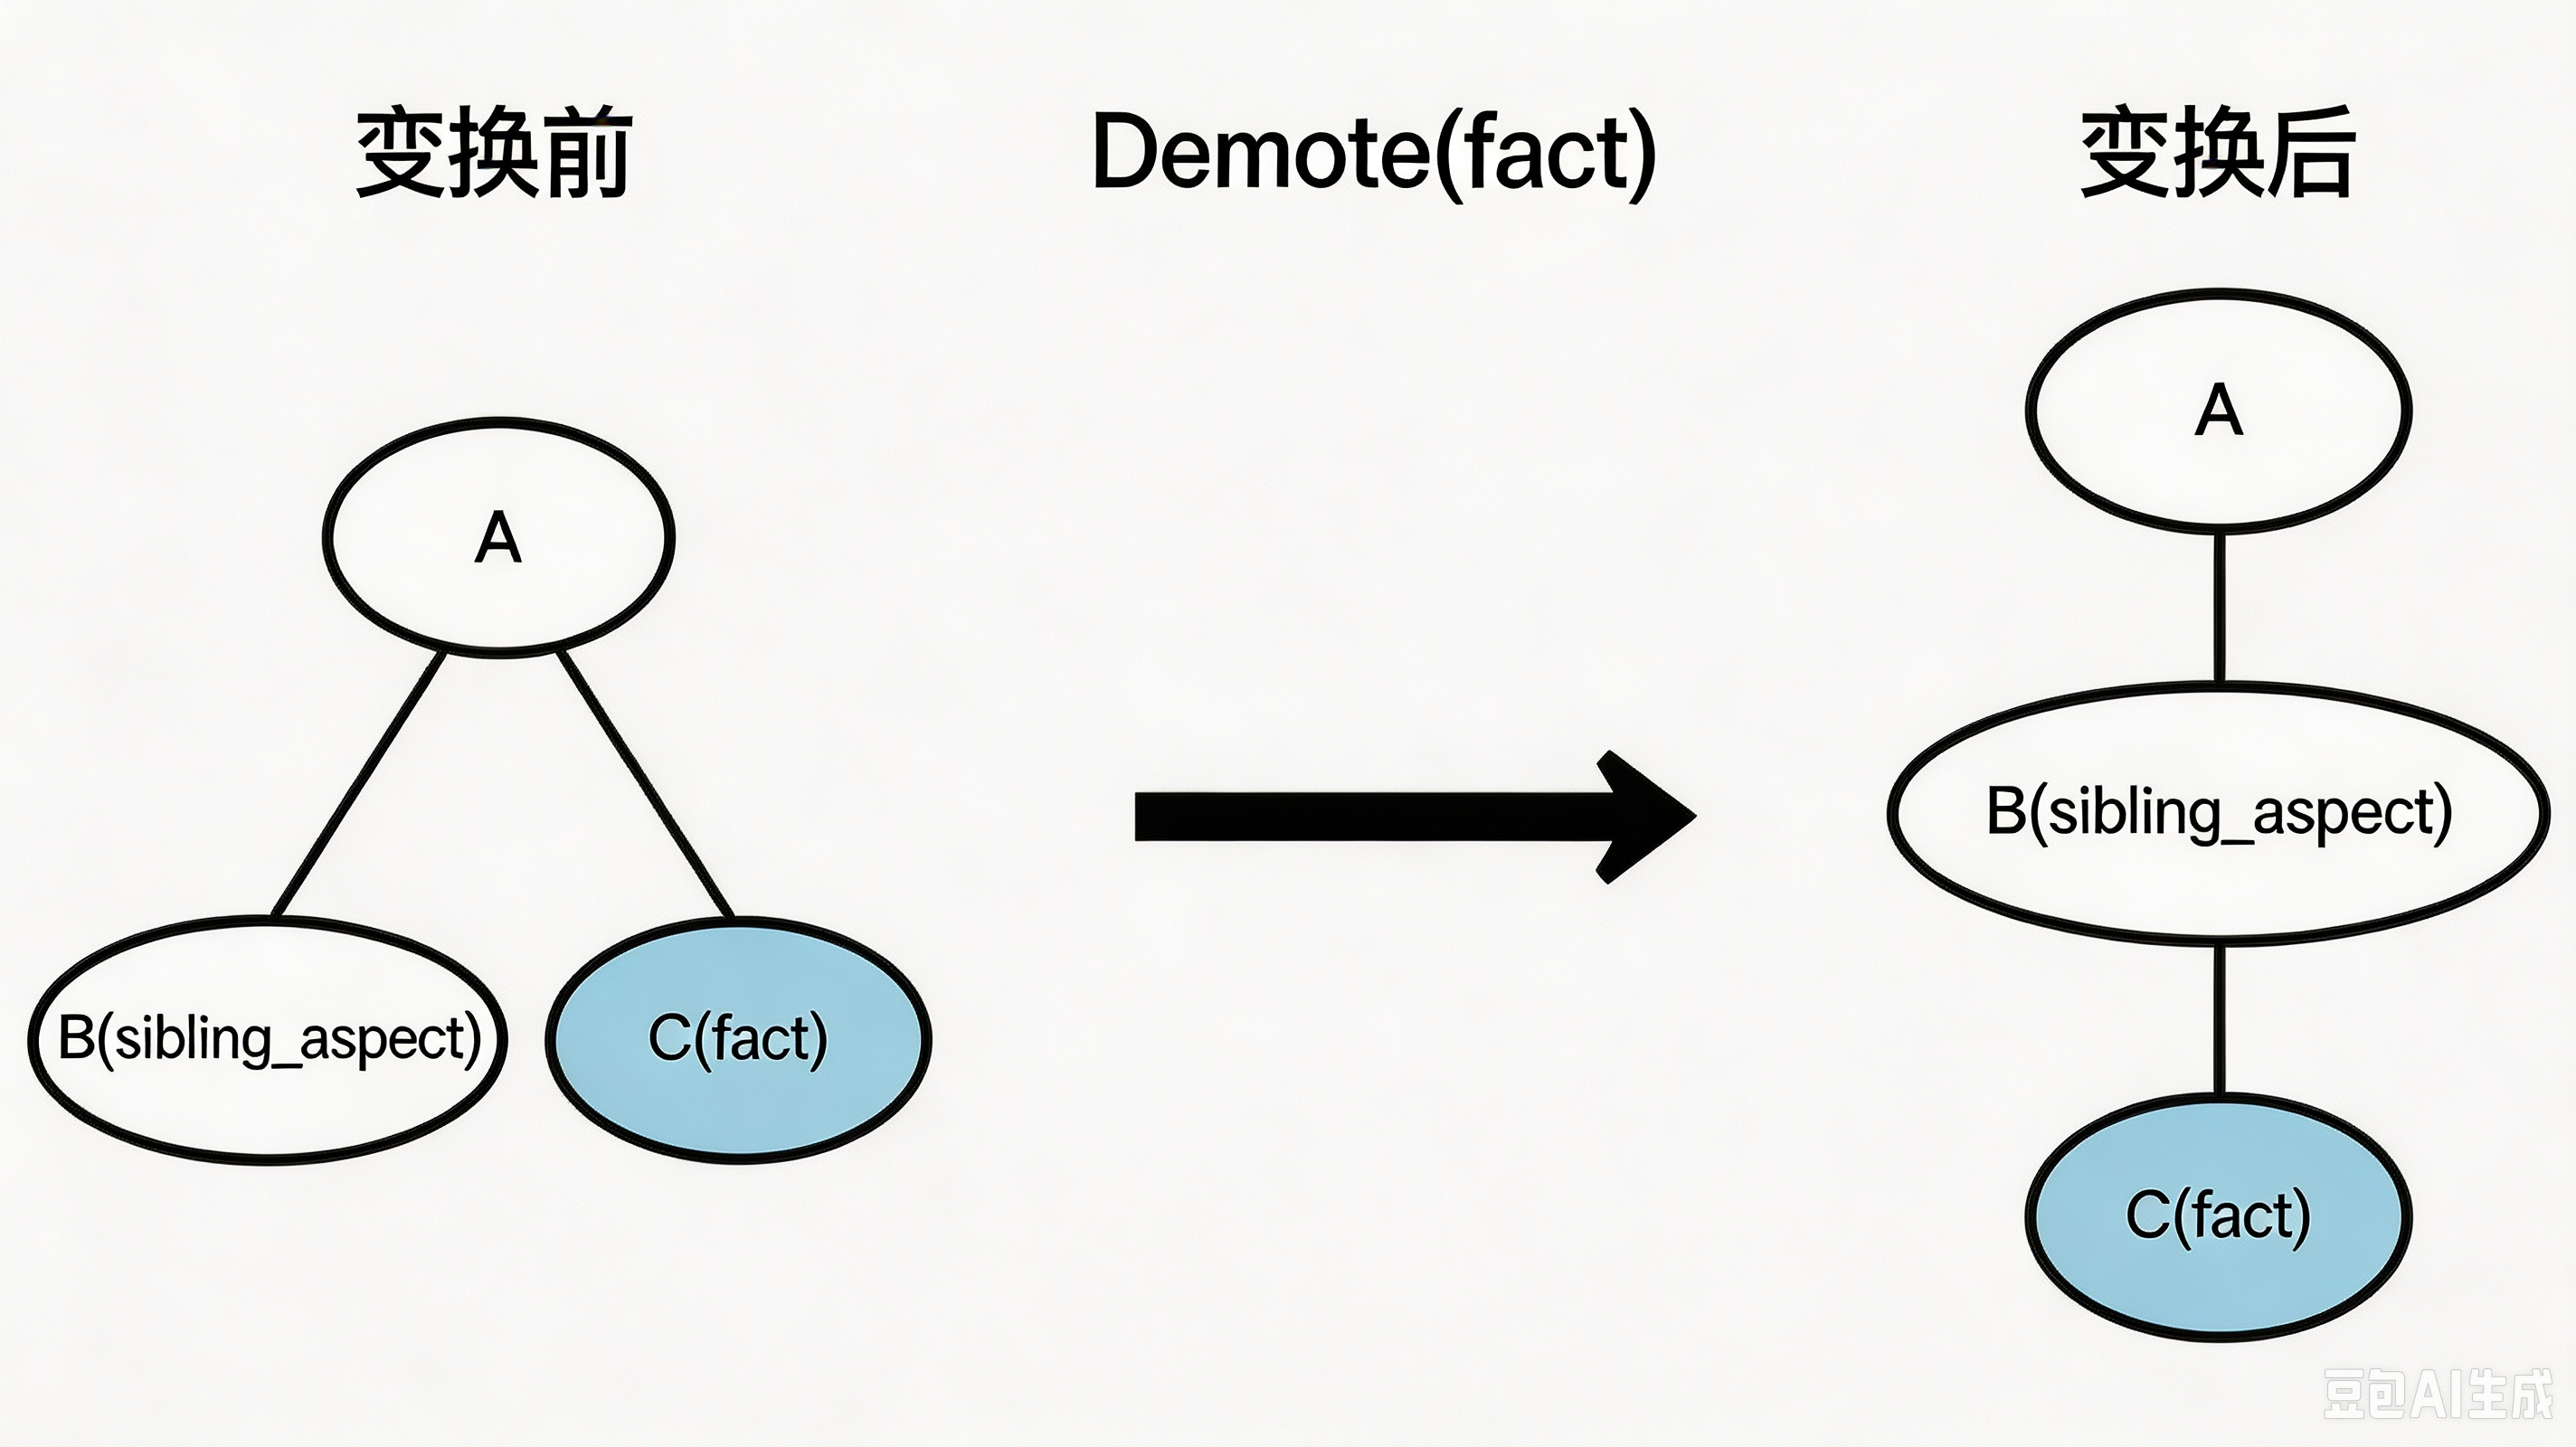
- Group 把一堆fact放一起,做一个新的aspect为他们的parent,然后这个新aspect的parent是他们的老parent
def Group(facts):
    # Assert all fact in facts have same parent
    old_parent = facts[0].parent
    new_aspect = create_new_aspect(facts)
    new_aspect.parent = old_parent
    for fact in facts:
        old_parent.children.remove(fact)
        new_aspect.children.append(fact)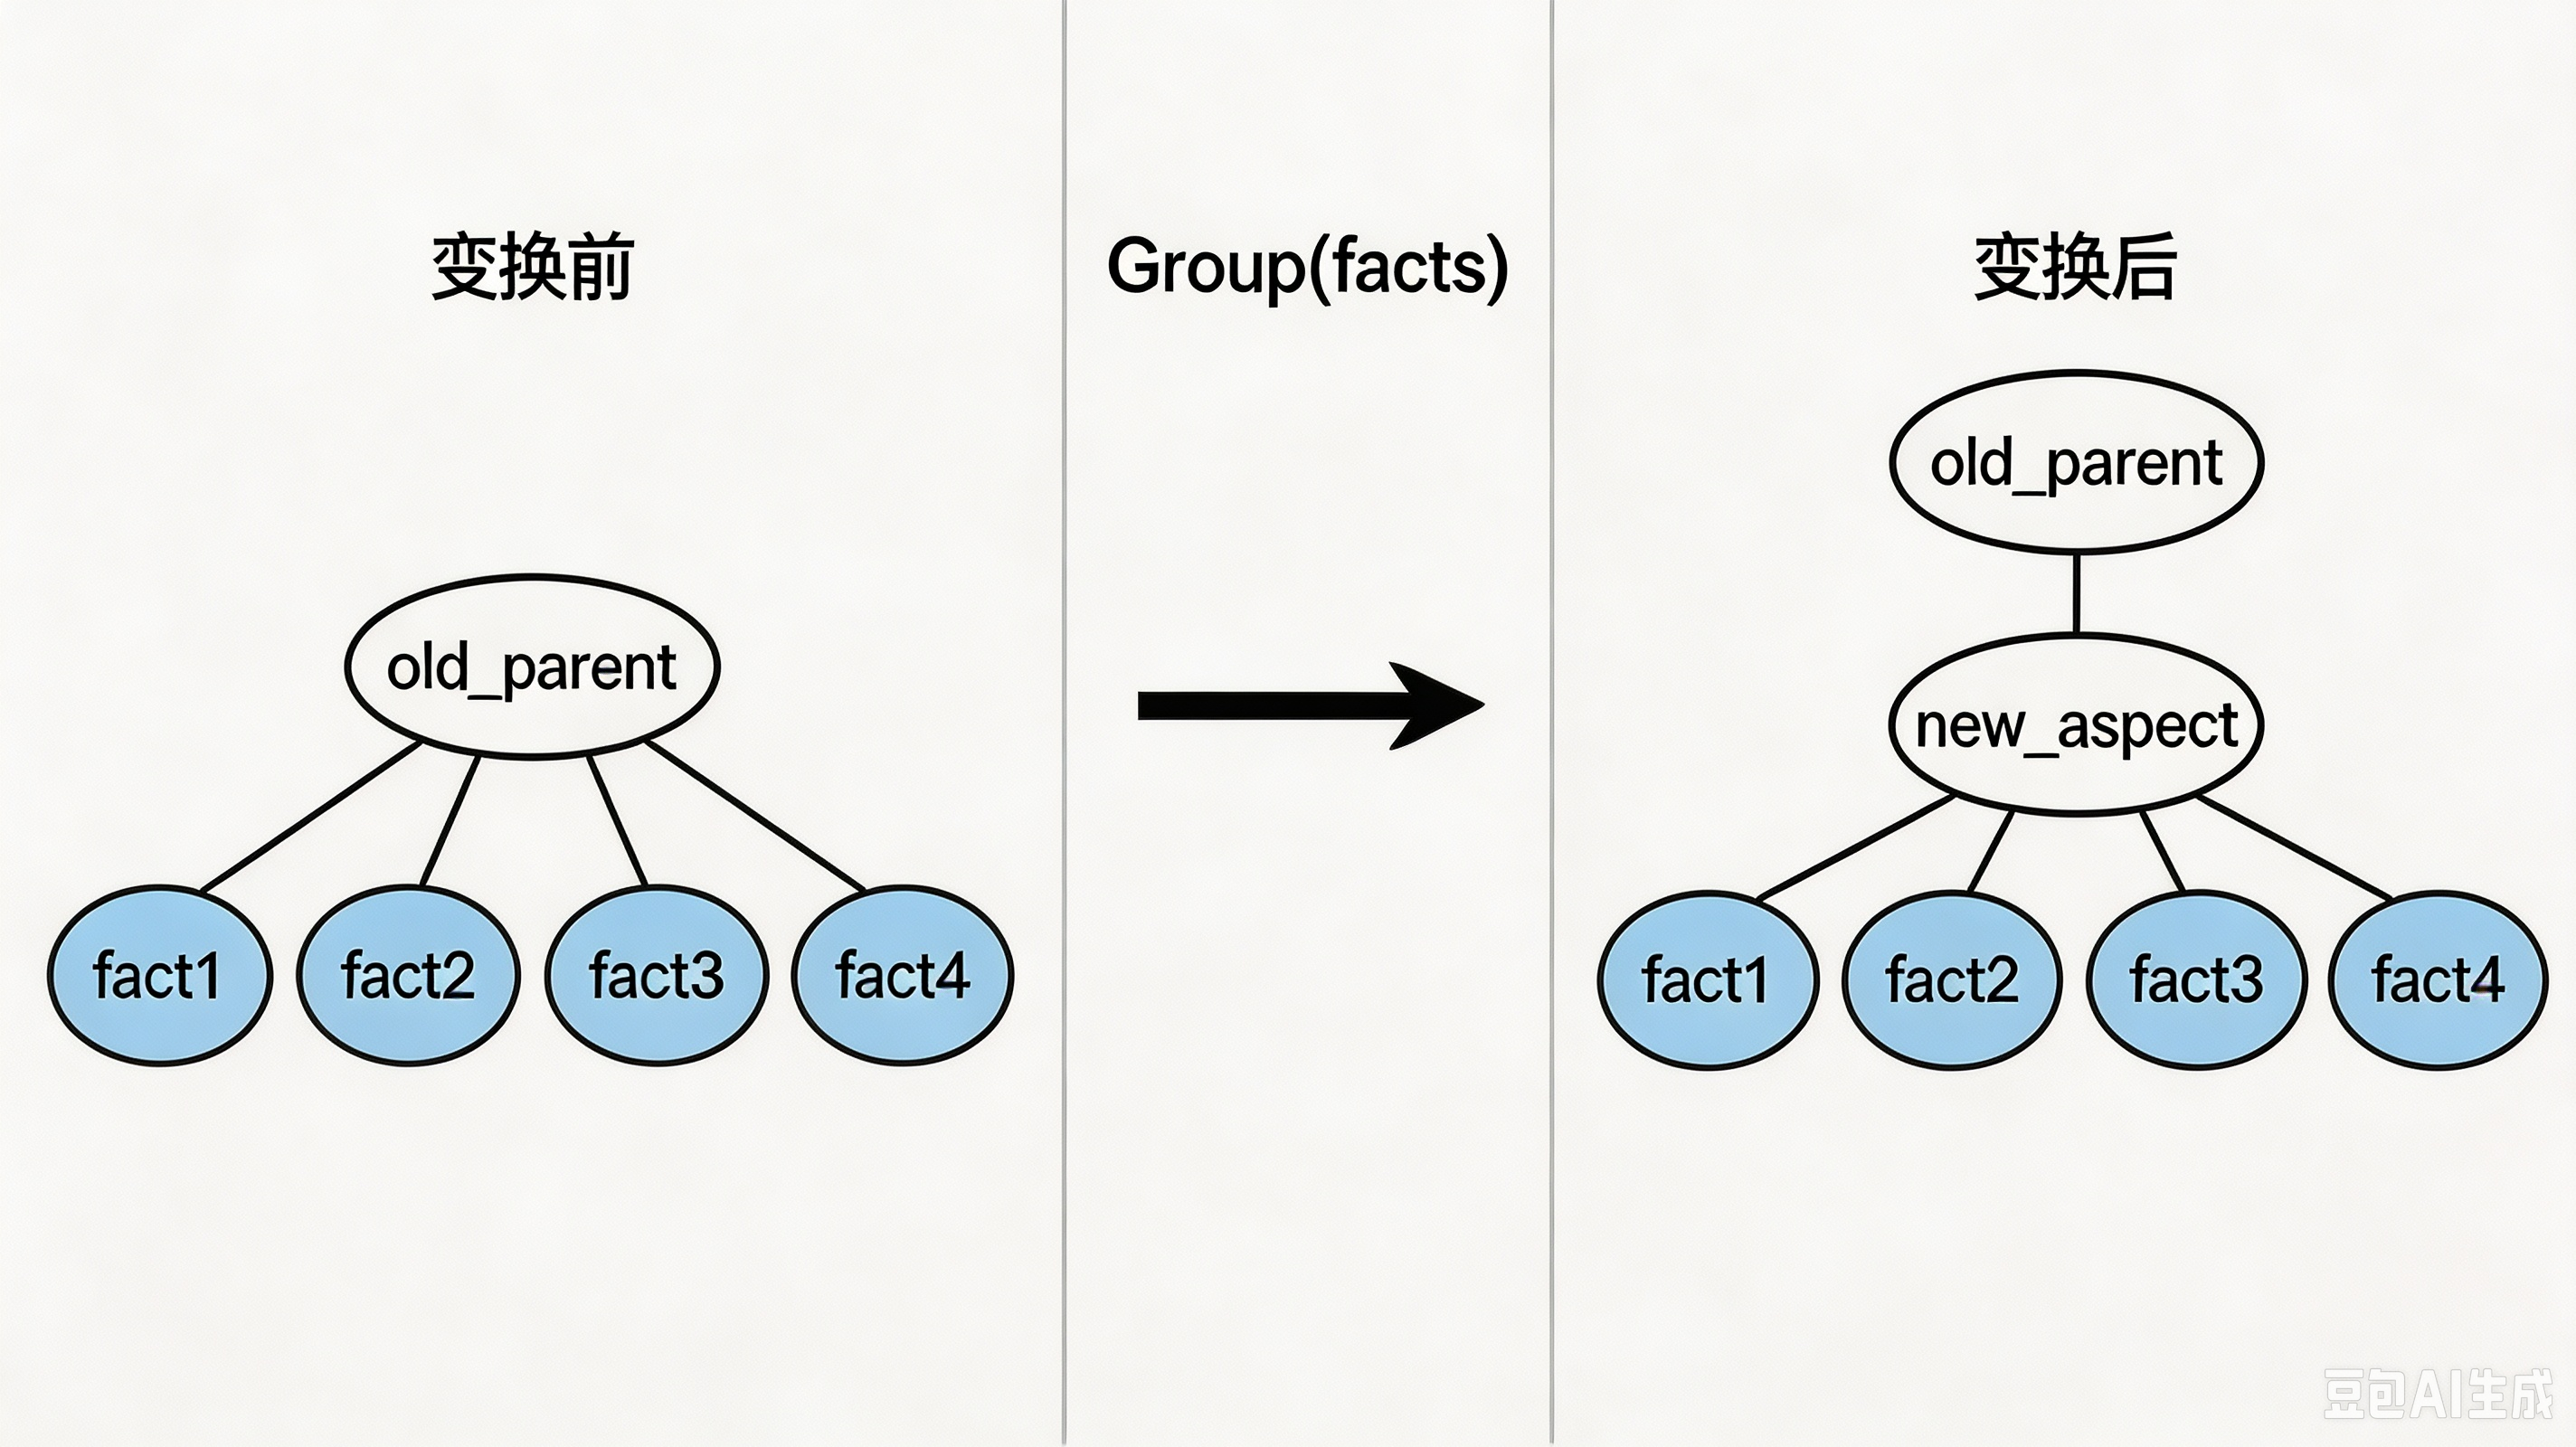
- Idle 什么都不做
def idle():
returnstage2 network#
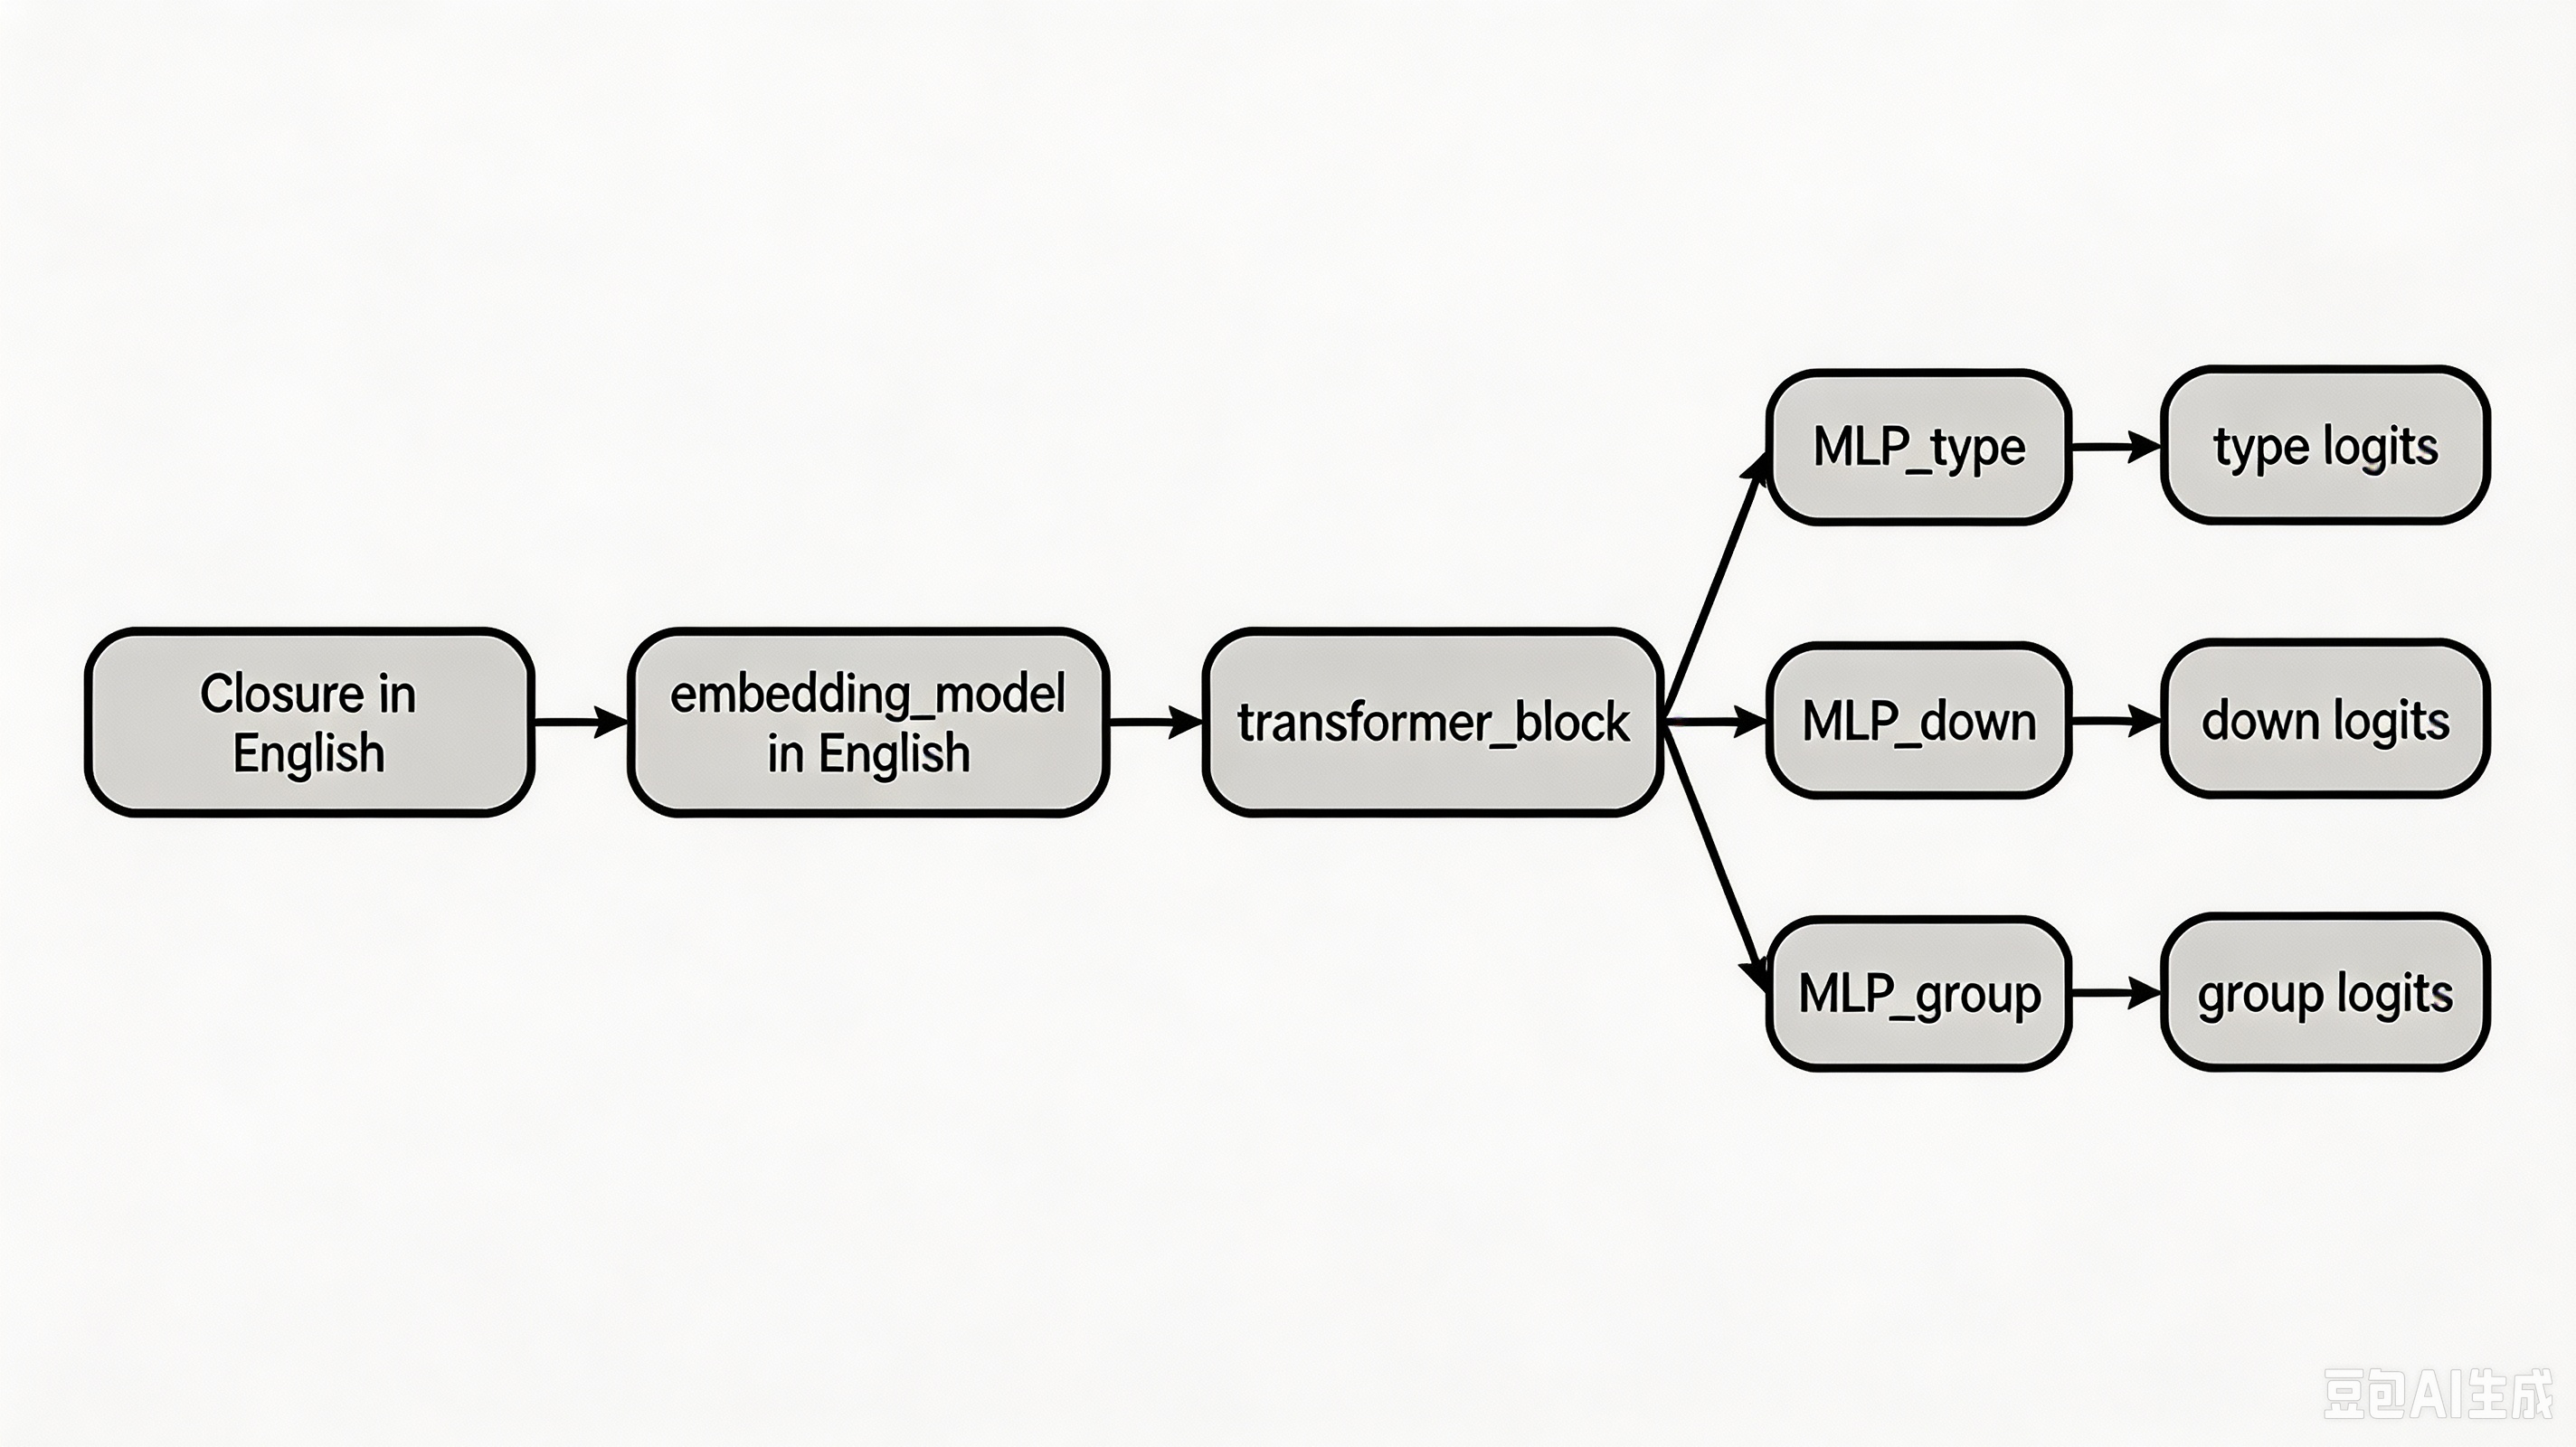
这里比较复杂,这个网络吃进去一个闭包,输出三个logits,分别代表:每个node做什么类型动作,Demote动作的对象,Group动作的对象
整个过程要借助一个额外的概率图模型和势函数,以及一个规划优化器来完成,这里不展开,先默认通过这三个logits可以得到一系列动作就行
训练#
采用MLE训练,简单来说,这是一个在线的训练,每当模型需要做决策的时候,比如说stage1挂在哪里,stage2怎么调整,就去问问llm怎么做, 然后用模型产出的logits和llm给的ground truth做CE loss训练就好了
具体场景#
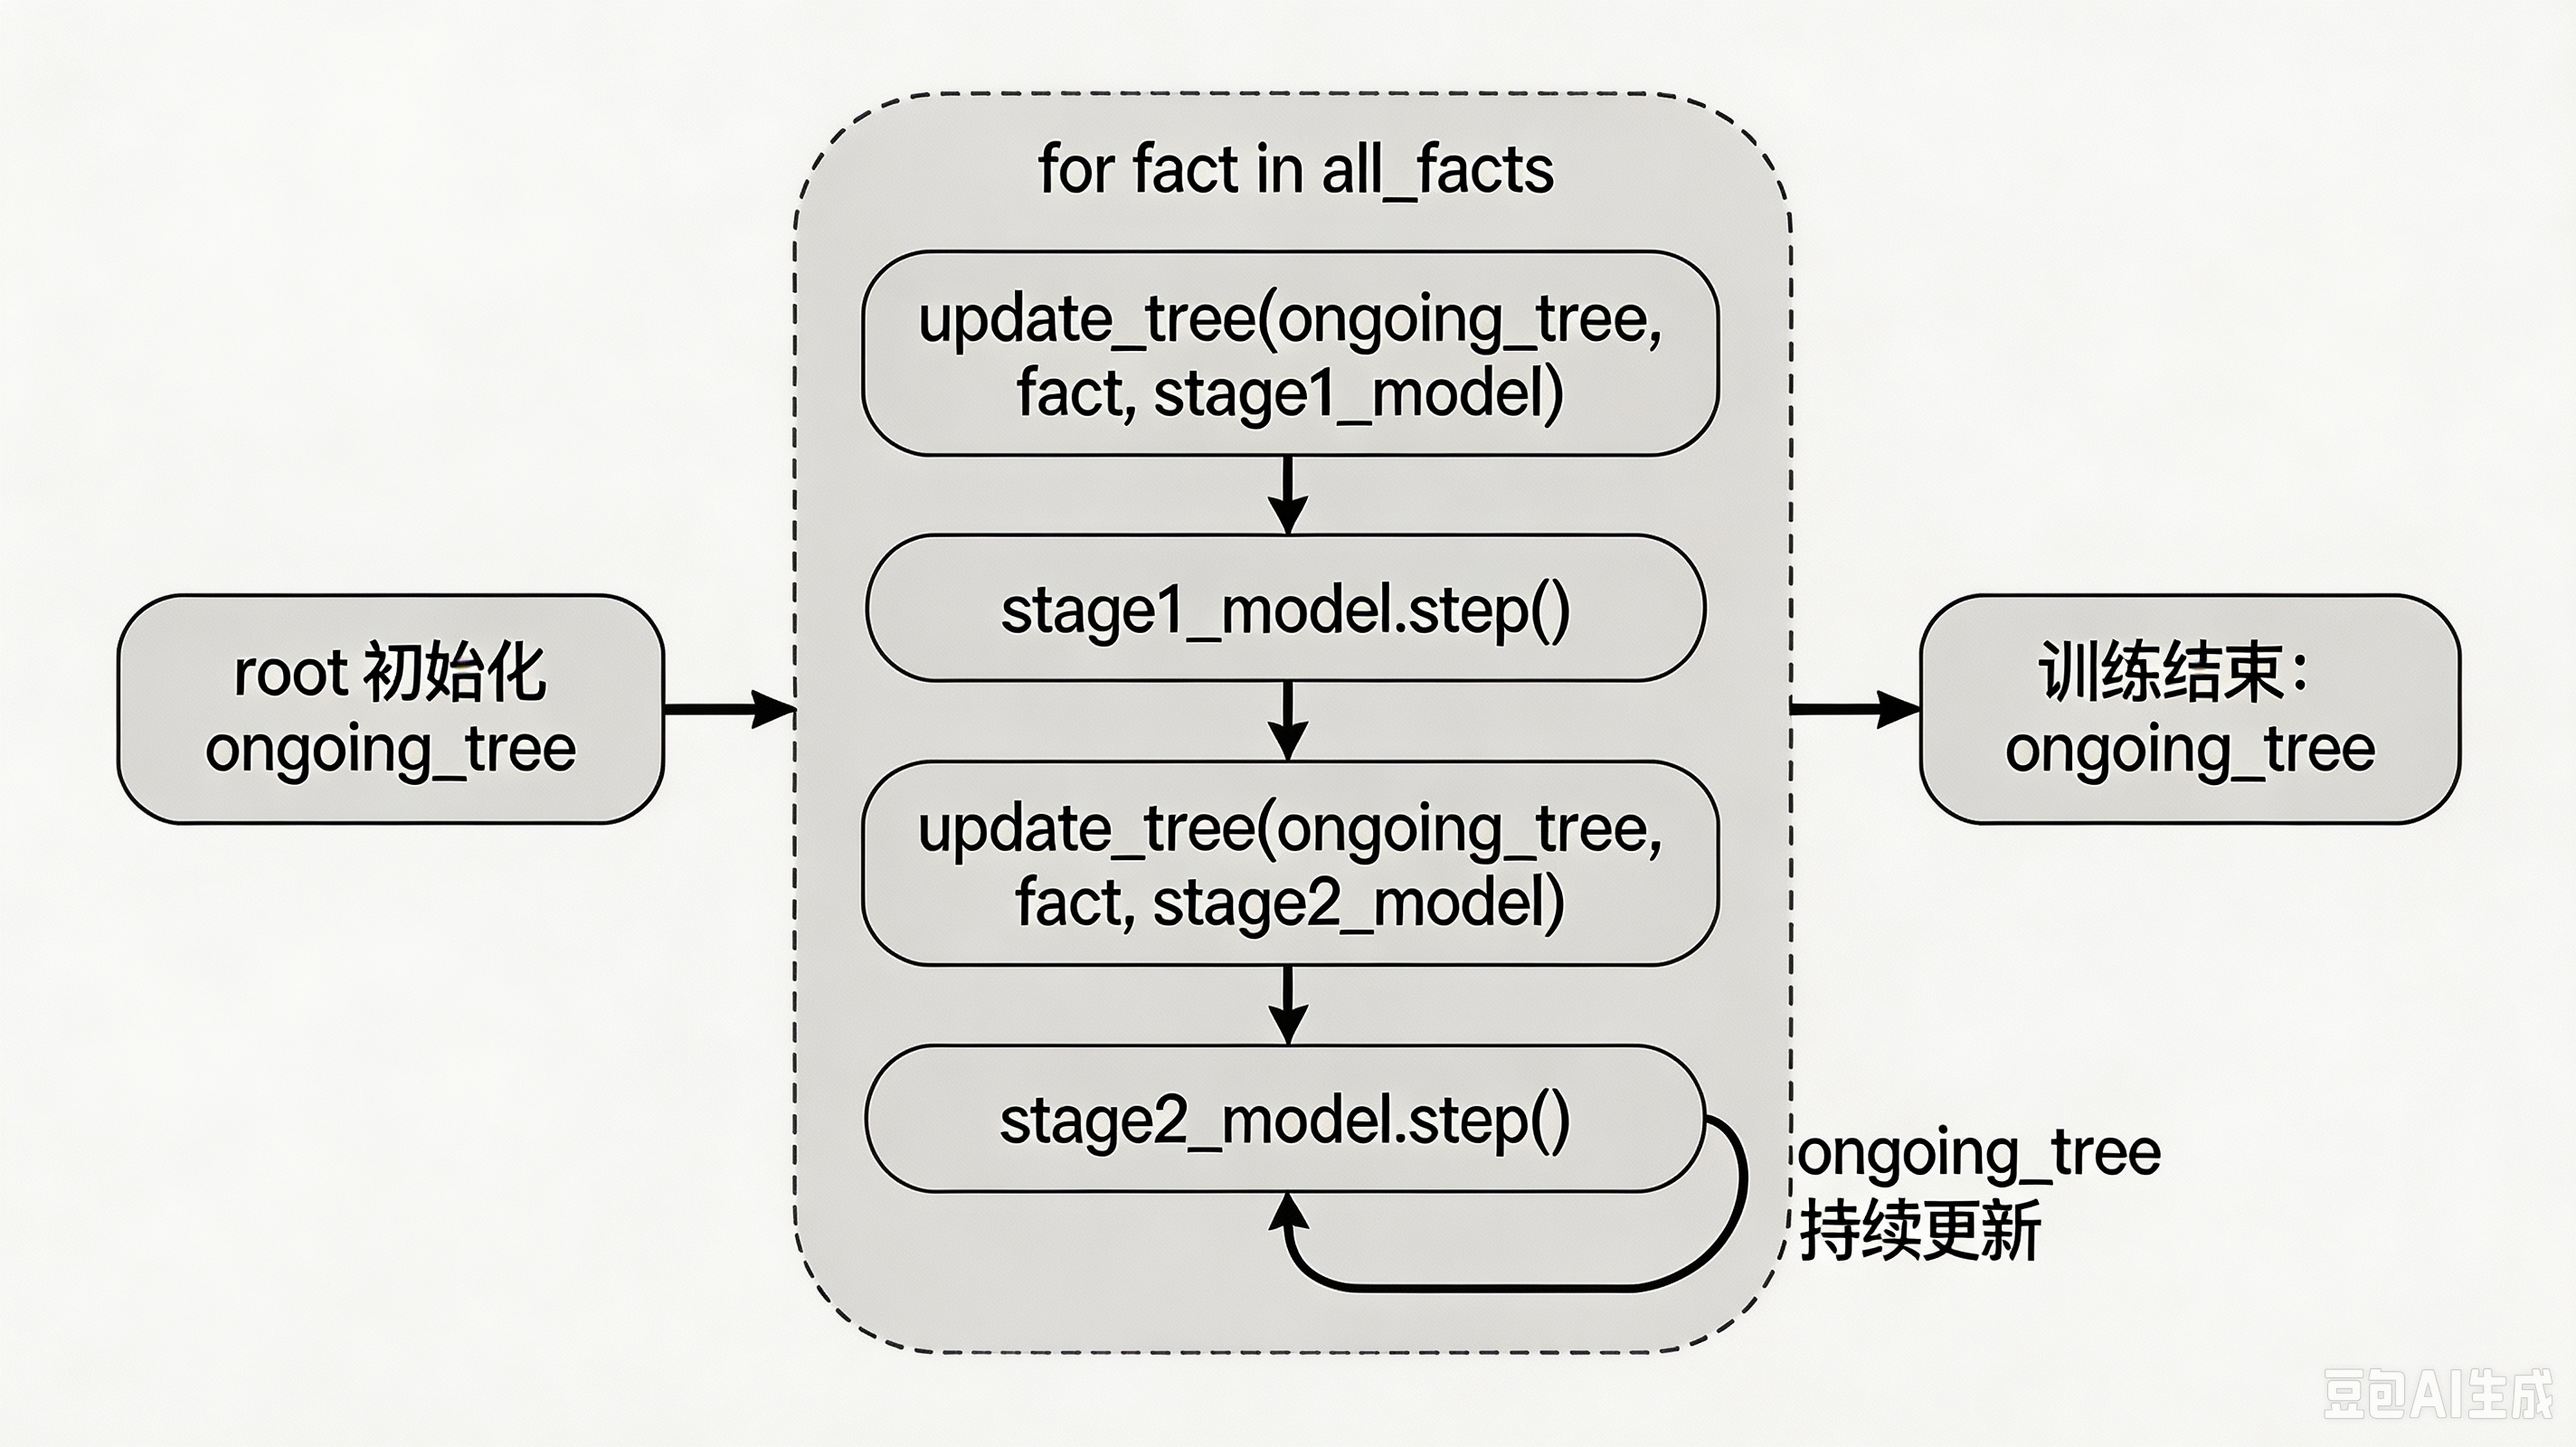
想象一下有一堆fact node是零散的,现在我要把它拼出一棵树来,那实际上就是来一个fact走一遍stage1和stage2,然后树长大一截,在这个过程当中 训练就是自然而然的事情了
ongoing_tree = root
for fact in all_facts:
    ongoing_tree = update_tree(ongoing_tree, fact, stage1_model)
    stage1_model.step()

    ongoing_tree = update_tree(ongoing_tree, fact, stage2_model)
stage2_model.step()上面要讲两点,第一就是我可以不执行我自己model作出的决策,而执行LLM给的ground truth让ongoing_tree长大,其二就是可以不每次都更新模型, 可以把梯度攒起来到了batch_size再更新