文档说明#
本文档说明数据集的制作方式
长程对话到树#
假设我们有一个Locomo10那样的双人长程对话,那么LLM可以很轻松的从其中抽取出fact和树来,他只要自行判断对话当中的事实 属于什么对象就行了,通俗理解就是replay session, 等到session重放了一遍树也就做出来了,
树的分布不均#
实验证明一个长程对话大概能抽取出5-6颗树,但是如果不加限制(如LocoMo那样),容易出现不均,即对话的双方各占了一颗树,然后这两棵树 可能总共占了90%以上的fact,剩下的树基本上是空的
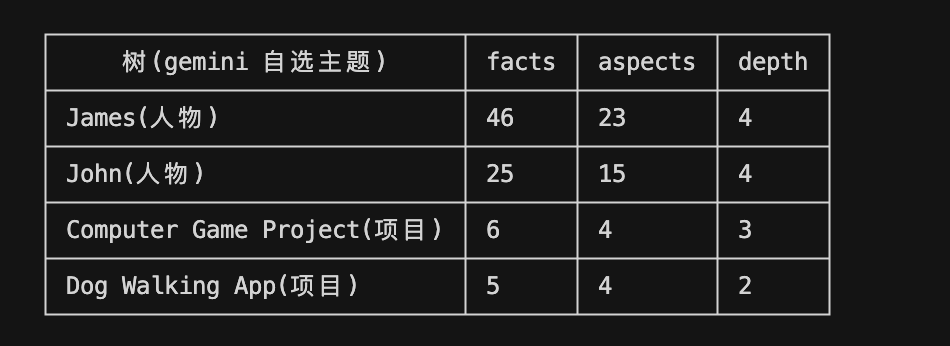
上面这个图是从真实的一个locomo10数据集里面的一个长程对话(的一部分)抽出来的4颗树,明显这个对话就是James和John之间的对话, 但是LLM可能识别到其他两个项目也算主体,所以又弄了两棵树,但是fact很少,约等于没有,所以如果我们照着Locomo去造对话的话,大概率会有这个问题
对话的要求#
所以我们需要这样的长程对话:这个长程对话由若干个session组成,最后LLM可以从这个对话里面抽出若干棵树,然后每棵树的fact数量要差不多
如此一来不妨用一个跨session的配平算法来达到这个目的,对话的长度不需要先验的设定,fact不够就让他继续顺下去说就可以了
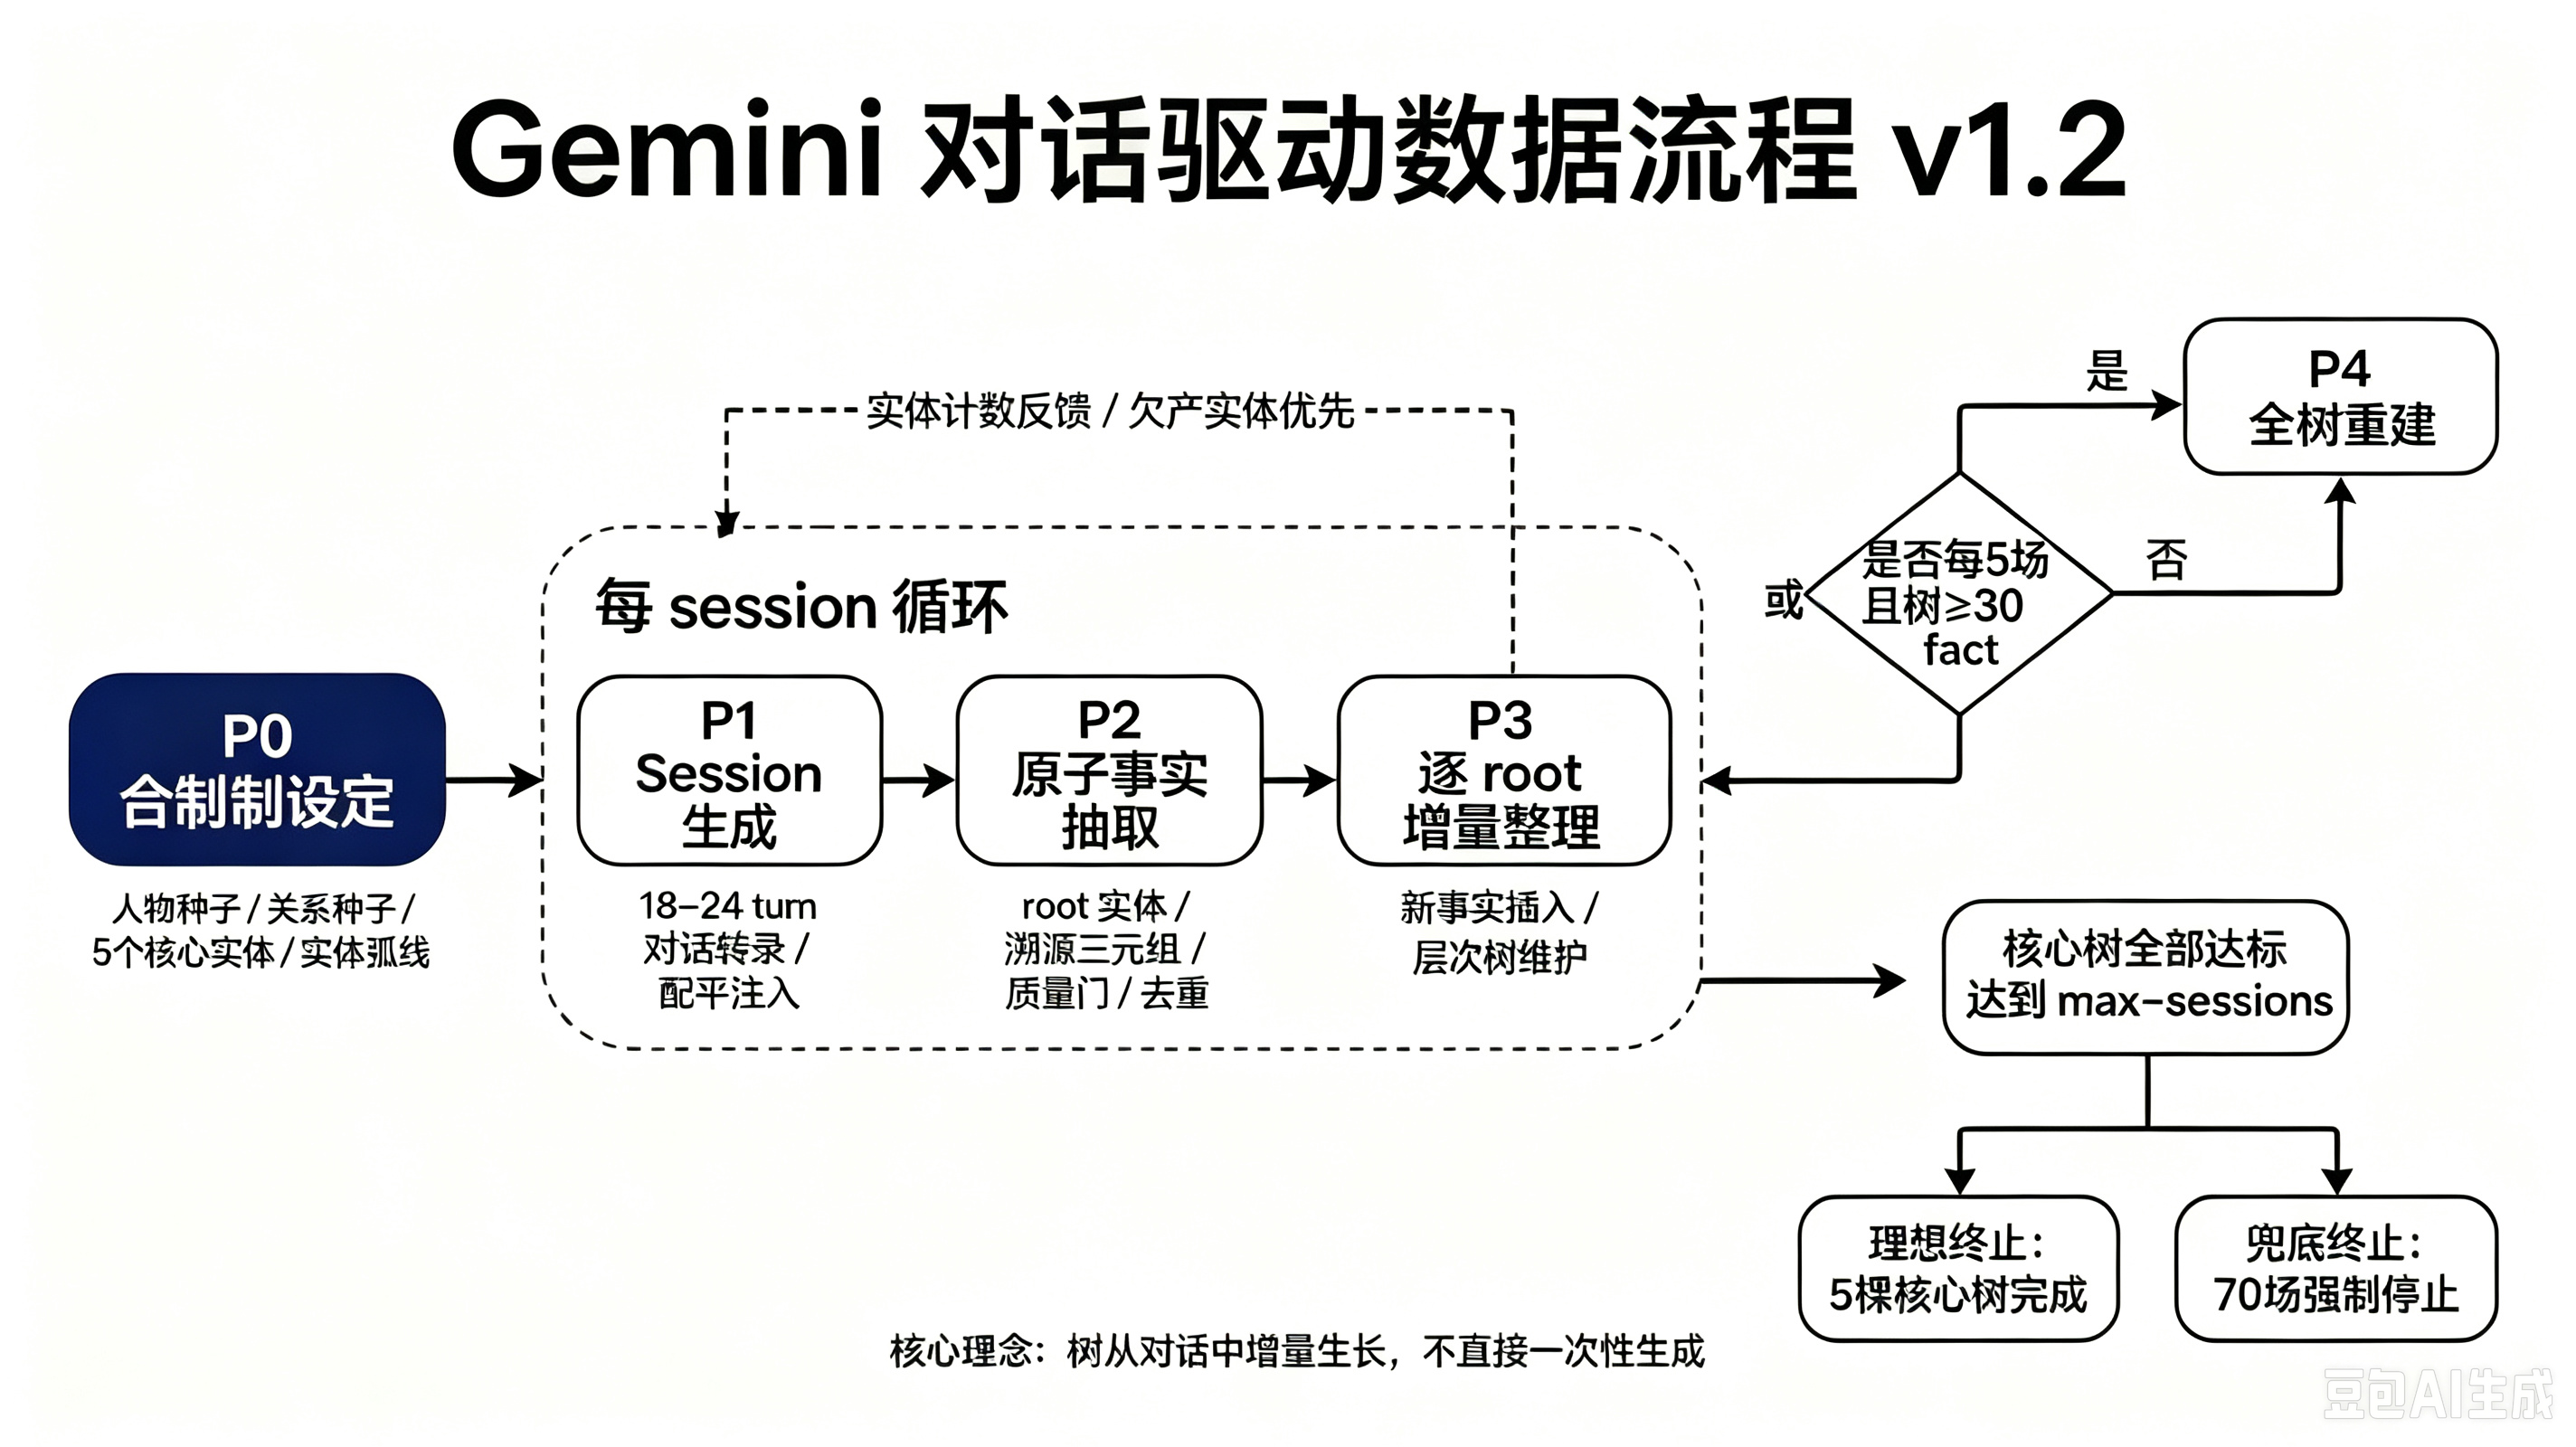
如此一来的话,对话和树都有了,但是作为训练数据集我们不需要对话,把树存下来就好了
树的例子#
来看两件事情:第一是LLM能从一个多轮对话里面抽出几颗什么样的树,第二就是随机的抽一棵树看树的结构如何
我们希望的是:树和树之间,深度和fact数量要差不多,树内上下级关系合理,不要出现极端深度/flat的情况
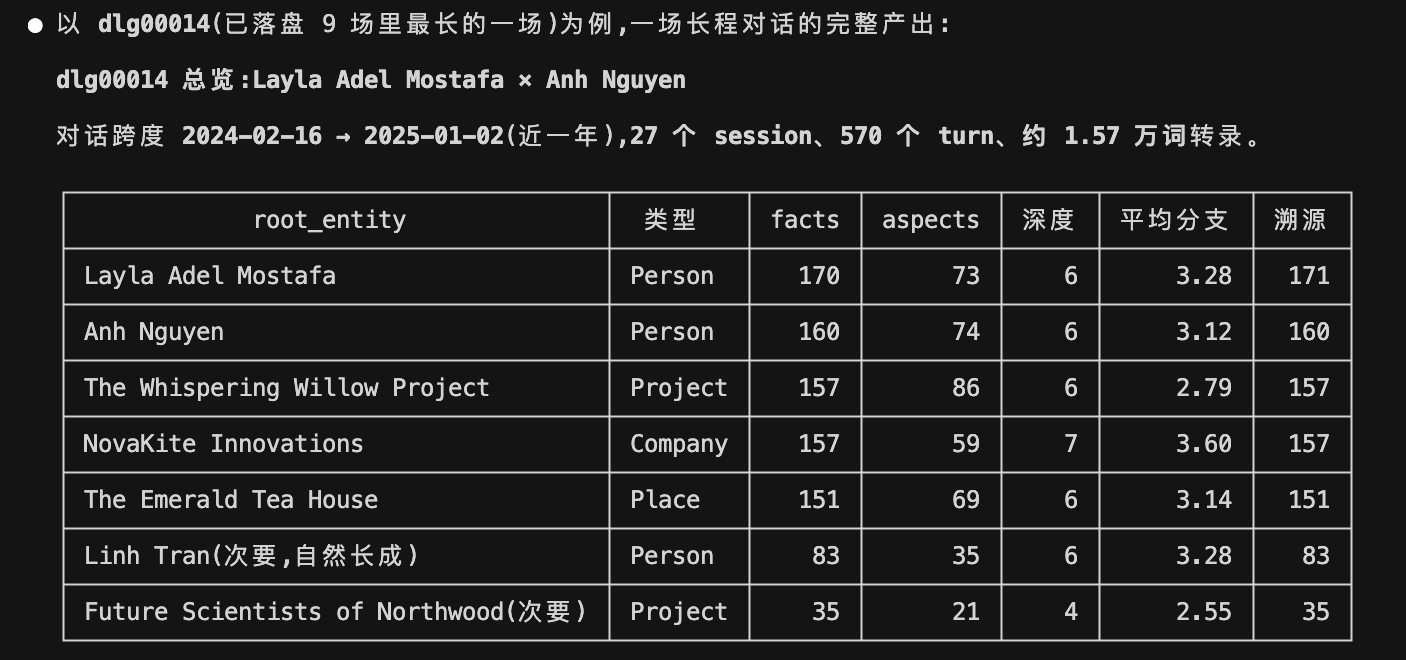
最下面两颗树是副产物,不列入正式训练的,可以看到在这一场Layla和Anh的长对话当中,弄出了5颗fact和深度都差不多的树,达到了我们的要求
再来挑一棵树看看结构
# 树结构样例(gemini 产,production100 / dlg00017)
# root: Sofia Ramirez  (Person)
# facts=185  目录=aspect(保留名字便于读结构),叶子=fact(仅编号不展开内容)
#──────────────────────────────────────────────────────────────────────

Sofia Ramirez/   [ROOT]
├── Professional Life/
│   ├── Medical Training & Certifications/
│   │   └── Advanced Trauma Life Support (ATLS) Program/
│   │       ├── Program Overview & Enrollment/
│   │       │   ├── Program Details/
│   │       │   │   ├── fact_001
│   │       │   │   ├── fact_002
│   │       │   │   └── fact_003
│   │       │   └── Enrollment & Schedule/
│   │       │       ├── fact_004
│   │       │       ├── fact_005
│   │       │       ├── fact_006
│   │       │       └── fact_007
│   │       ├── Pre-Course Preparation/
│   │       │   ├── fact_008
│   │       │   ├── fact_009
│   │       │   └── fact_010
│   │       ├── Course Modules & Progress/
│   │       │   ├── Early Modules (Assessment & Airway)/
│   │       │   │   ├── fact_011
│   │       │   │   ├── fact_012
│   │       │   │   ├── fact_013
│   │       │   │   ├── fact_014
│   │       │   │   ├── fact_015
│   │       │   │   ├── fact_016
│   │       │   │   └── fact_017
│   │       │   └── Later Modules (Shock & Trauma Assessment)/
│   │       │       ├── fact_018
│   │       │       └── fact_019
│   │       ├── Practicals & Assessments/
│   │       │   ├── fact_020
│   │       │   ├── fact_021
│   │       │   ├── fact_022
│   │       │   ├── fact_023
│   │       │   └── fact_024
│   │       └── Course Completion/
│   │           ├── fact_025
│   │           ├── fact_026
│   │           └── fact_027
│   └── Emergency Medical Services (EMS) Role/
│       ├── Coastline EMS Employment/
│       │   ├── fact_028
│       │   └── fact_029
│       ├── Incident Responses/
│       │   ├── February 2024 Incidents/
│       │   │   └── fact_030
│       │   ├── March 2024 Incidents/
│       │   │   ├── fact_031
│       │   │   ├── fact_032
│       │   │   ├── fact_033
│       │   │   ├── fact_034
│       │   │   ├── fact_035
│       │   │   └── fact_036
│       │   └── May 2024 Incidents/
│       │       └── fact_037
│       └── Recognition & Awards/
│           ├── fact_038
│           └── fact_039
└── Personal Pursuits/
    ├── Fitness & Athletics/
    │   ├── Boxing Training/
    │   │   ├── Training Progress & General Outcomes/
    │   │   │   ├── fact_040
    │   │   │   ├── fact_041
    │   │   │   ├── fact_042
    │   │   │   ├── fact_043
    │   │   │   ├── fact_044
    │   │   │   └── fact_045
    │   │   ├── Sparring Sessions/
    │   │   │   ├── Past Sparring Sessions/
    │   │   │   │   ├── fact_046
    │   │   │   │   └── fact_047
    │   │   │   └── Upcoming Sparring Sessions/
    │   │   │       ├── fact_048
    │   │   │       ├── fact_049
    │   │   │       ├── fact_050
    │   │   │       └── fact_051
    │   │   ├── Competition Results & Specific Victories/
    │   │   │   ├── Past Competitions (Pre-October 2024)/
    │   │   │   │   ├── fact_052
    │   │   │   │   ├── fact_053
    │   │   │   │   ├── fact_054
    │   │   │   │   ├── fact_055
    │   │   │   │   ├── fact_056
    │   │   │   │   ├── fact_057
    │   │   │   │   └── fact_058
    │   │   │   └── October 2024 Golden Gloves Bout/
    │   │   │       ├── Bout Details & Outcome/
    │   │   │       │   ├── fact_059
    │   │   │       │   ├── fact_060
    │   │   │       │   ├── fact_061
    │   │   │       │   ├── fact_062
    │   │   │       │   ├── fact_063
    │   │   │       │   ├── fact_064
    │   │   │       │   └── fact_065
    │   │   │       └── Post-Bout Recovery/
    │   │   │           ├── fact_066
    │   │   │           └── fact_067
    │   │   └── Coach & Training Regimen/
    │   │       ├── fact_068
    │   │       ├── fact_069
    │   │       ├── fact_070
    │   │       ├── fact_071
    │   │       ├── fact_072
    │   │       ├── fact_073
    │   │       ├── fact_074
    │   │       └── fact_075
    │   ├── Incline Climbing/
    │   │   ├── fact_076
    │   │   └── fact_077
    │   └── Strength & Plyometrics Training/
    │       ├── Overall Goals & Achievements/
    │       │   ├── fact_078
    │       │   ├── fact_079
    │       │   ├── fact_080
    │       │   ├── fact_081
    │       │   └── fact_082
    │       └── Plyometrics Training Details/
    │           ├── fact_083
    │           ├── fact_084
    │           ├── fact_085
    │           └── fact_086
    ├── The Summit Seekers Project/
    │   ├── Project Foundation & Vision/
    │   │   ├── Project Naming & Core Vision/
    │   │   │   ├── fact_087
    │   │   │   └── fact_088
    │   │   ├── Charity & Educational Focus/
    │   │   │   ├── fact_089
    │   │   │   ├── fact_090
    │   │   │   ├── fact_091
    │   │   │   └── fact_092
    │   │   └── Team Members/
    │   │       ├── fact_093
    │   │       └── fact_094
    │   ├── Project Planning & Development/
    │   │   ├── Website & Initial Setup/
    │   │   │   └── fact_095
    │   │   ├── Coordination & Meetings/
    │   │   │   ├── fact_096
    │   │   │   ├── fact_097
    │   │   │   ├── fact_098
    │   │   │   └── fact_099
    │   │   ├── Workshops & Community Engagement/
    │   │   │   ├── fact_100
    │   │   │   ├── fact_101
    │   │   │   ├── fact_102
    │   │   │   └── fact_103
    │   │   └── Expert Feedback & Revisions/
    │   │       ├── fact_104
    │   │       ├── fact_105
    │   │       ├── fact_106
    │   │       ├── fact_107
    │   │       └── fact_108
    │   ├── Expeditions & Treks/
    │   │   ├── Appalachian Trail Trek/
    │   │   │   ├── fact_109
    │   │   │   └── fact_110
    │   │   ├── Patagonia Expedition Planning/
    │   │   │   ├── Route & Permits/
    │   │   │   │   ├── fact_111
    │   │   │   │   ├── fact_112
    │   │   │   │   ├── fact_113
    │   │   │   │   ├── fact_114
    │   │   │   │   ├── fact_115
    │   │   │   │   └── fact_116
    │   │   │   └── Equipment Budget/
    │   │   │       ├── fact_117
    │   │   │       └── fact_118
    │   │   └── Chile Expedition/
    │   │       ├── Travel Logistics & Preparations/
    │   │       │   ├── fact_119
    │   │       │   ├── fact_120
    │   │       │   └── fact_121
    │   │       ├── Equipment & Resources/
    │   │       │   ├── fact_122
    │   │       │   ├── fact_123
    │   │       │   ├── fact_124
    │   │       │   ├── fact_125
    │   │       │   ├── fact_126
    │   │       │   └── fact_127
    │   │       └── Community Engagement & Research/
    │   │           ├── fact_128
    │   │           ├── fact_129
    │   │           ├── fact_130
    │   │           ├── fact_131
    │   │           └── fact_132
    │   ├── Fundraising & Outreach/
    │   │   ├── Grant Applications/
    │   │   │   ├── fact_133
    │   │   │   ├── fact_134
    │   │   │   └── fact_135
    │   │   ├── Sponsorships & Partnerships/
    │   │   │   ├── fact_136
    │   │   │   ├── fact_137
    │   │   │   ├── fact_138
    │   │   │   └── fact_139
    │   │   ├── Fundraising Events/
    │   │   │   ├── fact_140
    │   │   │   ├── fact_141
    │   │   │   ├── fact_142
    │   │   │   └── fact_143
    │   │   └── Donor Relations & Community Outreach/
    │   │       ├── fact_144
    │   │       └── fact_145
    │   ├── Social Media Campaigns/
    │   │   └── Virtual Trail Clean-up Campaign/
    │   │       ├── Campaign Strategy & Launch/
    │   │       │   ├── fact_146
    │   │       │   └── fact_147
    │   │       └── Video Montage Production/
    │   │           ├── Initial Development & Review/
    │   │           │   ├── fact_148
    │   │           │   ├── fact_149
    │   │           │   ├── fact_150
    │   │           │   └── fact_151
    │   │           └── Black Forest Segment/
    │   │               ├── Segment Development/
    │   │               │   └── fact_152
    │   │               ├── Footage Acquisition Challenges/
    │   │               │   ├── fact_153
    │   │               │   ├── fact_154
    │   │               │   ├── fact_155
    │   │               │   ├── fact_156
    │   │               │   └── fact_157
    │   │               ├── SkyView Productions Engagement/
    │   │               │   ├── fact_158
    │   │               │   ├── fact_159
    │   │               │   ├── fact_160
    │   │               │   ├── fact_161
    │   │               │   └── fact_162
    │   │               └── Segment Outcome/
    │   │                   └── fact_163
    │   └── Project Milestones & Future/
    │       ├── Key Events & Celebrations/
    │       │   ├── fact_164
    │       │   └── fact_165
    │       └── Summit Seekers 2.0/
    │           ├── Vision & Concepts/
    │           │   ├── fact_166
    │           │   ├── fact_167
    │           │   └── fact_168
    │           └── Planning & Collaboration/
    │               └── fact_169
    └── Social Life & Leisure/
        ├── Concerts & Events/
        │   ├── fact_170
        │   ├── fact_171
        │   └── fact_172
        └── Personal Affairs/
            ├── Personal Finances/
            │   └── fact_173
            ├── Personal Tasks & Possessions/
            │   ├── fact_174
            │   └── fact_175
            ├── Gifts & Personal Gear/
            │   ├── fact_176
            │   ├── fact_177
            │   ├── fact_178
            │   ├── fact_179
            │   ├── fact_180
            │   ├── fact_181
            │   └── fact_182
            ├── Property & Housing/
            │   ├── fact_183
            │   └── fact_184
            └── Activities with Miguel Ramirez/
                └── fact_185
类似于一个一开N的树,没什么大问题
Locomo就只有两个Person的树,为了让训练样本多一点,特意让他多造了一些树
警告#
这里有个工程经验,用LLM造树最好不要让他从上到下开始造,不然的话,很可能他会直接在你上面的aspect上扩写变成下面的fact,这会导致 两个文本相似度过高,有可能模型分不开