文档说明#
本文档记载一次MLE的预训练和极小的微调
实验数据#
从生成的长对话里面提取出来的树,总共100颗,88样本内,12val,树比较大,大概每棵树有150个fact+50个aspect,大概共200个节点
实验过程#
首先是用chatgpt-4o做标注,也就是对每个snapshot的closure,让gpt去决定应该做什么动作,这就得到了所有的(X,y),做监督学习
这些(X,y)做100个epoch的监督学习
结束之后,做online学习,但只做两个policy,online的成本非常高,2个epoch大概跑了10小时
评判结果#
从结构上来说,teacher(gpt)和student(小模型)做出来的树的aspect都比较少,至少比数据集里面的原树少得多
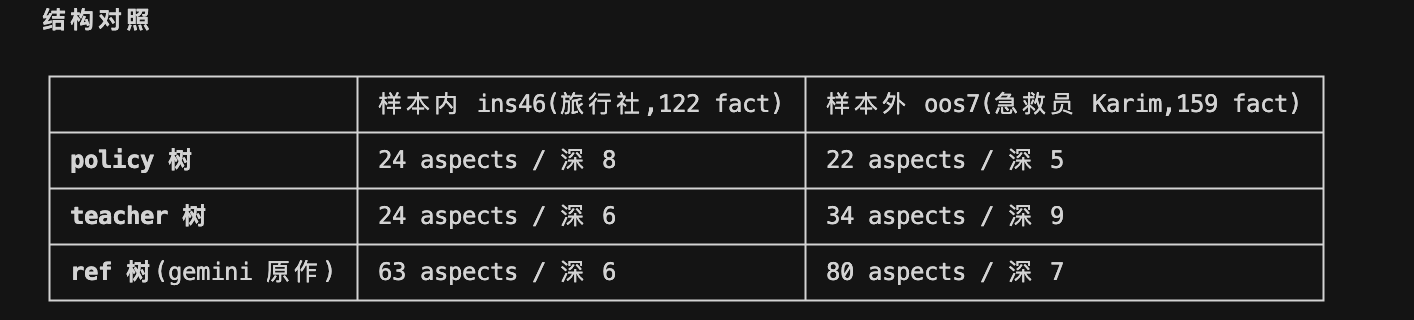
用gpt5.6-sol当强模型,直接分别给ref, teacher, student树打分如下(理论上student的分不可能超过teacher)
盘踞大概是这样:假如一棵树有100个fact,LLM去逐个判断每个fact和他父亲的关系的合理性,得到一个百分比,比如说50个fact是合理的,那这个值就是0.5
接下来再做很多次(比如说10次),这10次就把fact随机乱放,然后每次能得到一个百分比,这个百分比大概率很低,因为乱放可能只有5个fact合理,平均可能也是5%左右
然后再考虑超额,超额=树的合理百分比-随机乱放的平均百分比即可
当然了,因为随便乱放的baseline大概率趋于0,也可以不剪掉,直接看合理程度就行了
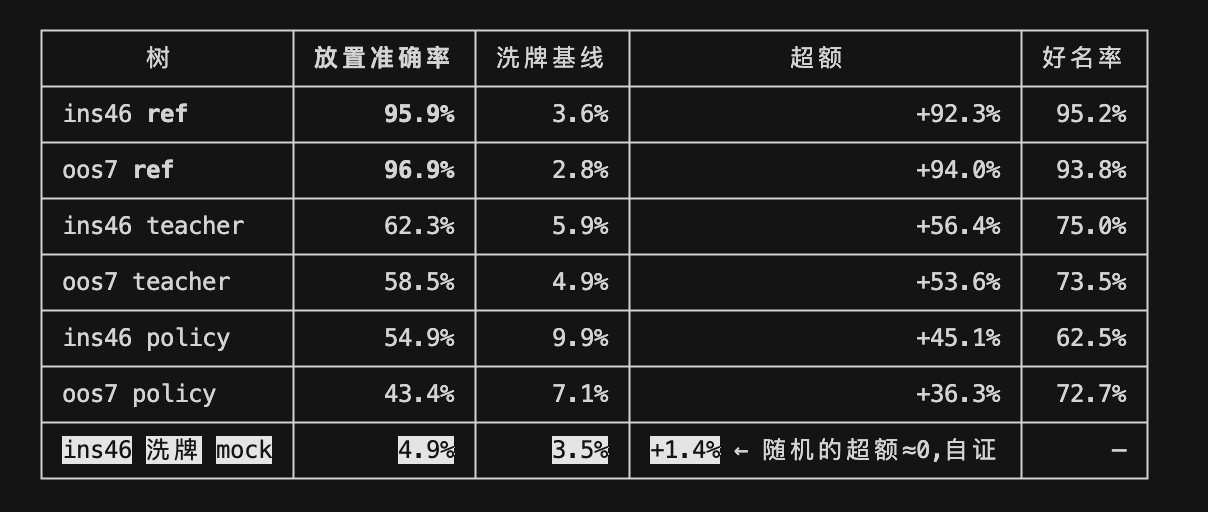
从这个图上可以看出来,teacher的质量其实也一般,或者说teacher在看不到ref_tree的情况下,应该不太可能做到比较好
生产结果#
我们用一棵树,分别展示他的ref/teacher/student
# ref
# REFERENCE tree task_id=46 entity='Company: Voyage Vista Travel'
# facts=122 aspects=63 max_depth=6 avg_branching=2.92
# policy rollout used the first max_facts=0 facts of this tree (BFS order)

[A] Voyage Vista Travel
  [A] Corporate Programs & Partnerships
    [A] Corporate Retreats Division
      [A] Program Development & Strategy
        [F:0] Voyage Vista Travel is brainstorming proposals for corporate team-building retreats.
        [F:1] Voyage Vista Travel plans to present proposals for corporate team-building retreats to local tech co
      [A] Synaptic Solutions Retreat (Costa Rica)
        [F:2] Voyage Vista Travel organized an adventure retreat for Synaptic Solutions.
        [F:3] The adventure retreat organized by Voyage Vista Travel was for 40 employees of Synaptic Solutions.
        [F:4] The adventure retreat organized by Voyage Vista Travel is a 5-day multi-activity trip.
        [F:5] The adventure retreat organized by Voyage Vista Travel is to the Costa Rican rainforest.
        [F:6] The adventure retreat organized by Voyage Vista Travel is scheduled for August 2023.
        [F:7] The adventure retreat organized by Voyage Vista Travel is worth over $75,000.
      [A] Syntel Systems Retreat (Redwood NP)
        [A] Program Details & Scope
          [F:8] Voyage Vista landed a massive corporate retreat program with Syntel Systems.
          [F:9] The corporate retreat program for Syntel Systems is for 50 employees.
          [F:10] The corporate retreat program for Syntel Systems is focused on team-building and leadership developm
          [F:11] The corporate retreat program for Syntel Systems is a four-day, three-night program.
          [F:12] The corporate retreat program for Syntel Systems is planned for Redwood National Park.
          [F:13] The corporate retreat program for Syntel Systems is scheduled for August 15th to August 18th.
          [F:14] The corporate retreat program for Syntel Systems includes guided hikes.
          [F:15] The corporate retreat program for Syntel Systems includes a conservation project.
        [A] Business Impact
          [F:16] The contract with Syntel Systems is a significant revenue boost for Voyage Vista.
          [F:17] The contract with Syntel Systems positions Voyage Vista for more corporate work.
      [A] TechSolutions Inc. Retreat (Whistler)
        [A] Proposal Phase
          [A] Initial Scope & Activities
            [F:18] Voyage Vista Travel landed its first big proposal for corporate team-building retreats.
            [F:19] Voyage Vista Travel's first big proposal is with TechSolutions Inc.
            [F:20] Voyage Vista Travel is proposing a week-long leadership and team-building retreat for TechSolutions
            [F:21] Voyage Vista Travel is planning guided backcountry skiing for the TechSolutions Inc. retreat.
            [F:22] Voyage Vista Travel is planning snowshoeing for the TechSolutions Inc. retreat.
            [F:23] Voyage Vista Travel is planning a 'build your own igloo' survival challenge for the TechSolutions In
          [A] Proposal Timeline
            [F:24] Voyage Vista Travel is working on the final proposal for TechSolutions Inc. during the week of Novem
            [F:25] Voyage Vista Travel is aiming for a client meeting with TechSolutions Inc. on November 17, 2023.
        [A] Execution & Logistics
          [A] Contract & Financials
            [F:26] Voyage Vista Travel landed the TechSolutions Inc. contract for their corporate retreat in Whistler.
            [F:27] The meeting for the TechSolutions Inc. contract happened on November 17, 2023.
            [F:28] Voyage Vista Travel received an initial deposit of $45,000 for the TechSolutions Inc. corporate retr
            [F:29] The total project value for the TechSolutions Inc. corporate retreat is estimated at $120,000.
          [A] Vendor Management & Challenges
            [F:30] The TechSolutions Inc. Whistler trip is scheduled for January 15, 2024.
            [F:31] Voyage Vista Travel hit a minor snag with ski and snowboard rentals for the TechSolutions Inc. Whist
            [F:32] Voyage Vista Travel's original vendor for ski and snowboard rentals was Alpine Peak Sports.
            [F:33] Alpine Peak Sports could not provide 45 sets of premium gear for the TechSolutions Inc. Whistler tri
            [F:34] Voyage Vista Travel secured a bulk deal with Whistler Blackcomb Gear Rentals for the ski and snowboa
            [F:35] The deal with Whistler Blackcomb Gear Rentals was at a 5% higher cost than the original vendor.
            [F:36] Voyage Vista Travel finalized Whistler Blackcomb Gear Rentals on December 28, 2023.
    [A] Strategic Partnerships
      [A] General Corporate Deals
        [F:37] Voyage Vista Travel closed a significant deal.
        [F:38] The deal confirms Voyage Vista Travel's niche in high-end corporate adventure travel.
      [A] EcoTrek Adventures Partnership (Sustainable Safaris)
        [A] Partnership Overview & Goals
          [F:39] The 'Sustainable Safaris' partnership with EcoTrek Adventures closed on January 31, 2024.
          [F:40] The 'Sustainable Safaris' partnership with EcoTrek Adventures met its $150,000 first-year goal.
        [A] Peruvian Highlands Trek Program
          [A] Program Schedule & Bookings
            [F:41] The first 'Peruvian Highlands Trek' group for Voyage Vista Travel's EcoTrek Adventures partnership i
            [F:42] Voyage Vista Travel has secured 8 bookings out of 12 available spots for the first 'Peruvian Highlan
            [F:43] The 'Peruvian Highlands Trek' group departs on April 10, 2024.
            [F:44] The 'Peruvian Highlands Trek' group's departure is scheduled for April 10, 2024.
          [A] Marketing & Preparation
            [F:45] The promotional materials for the 'Peruvian Highlands Trek' need to be ready by February 21, 2024.
  [A] Client Acquisition & Key Accounts
    [A] Sales & Lead Generation
      [A] Silicon Valley Outreach Events
        [F:46] Voyage Vista Travel hosted a successful tasting event on June 01, 2023.
        [F:47] The tasting event was for ten potential clients from various tech startups in Silicon Valley.
        [F:48] The tasting event featured ceviche and Pisco Sours.
      [A] Prospective Clients & Pipeline
        [F:49] Voyage Vista Travel secured a follow-up meeting with Zenith Innovations.
        [F:50] The follow-up meeting with Zenith Innovations is for a team-building retreat.
        [F:51] Securing Salesforce as a client would be huge for Voyage Vista Travel.
        [F:52] Securing Google as a client would be huge for Voyage Vista Travel.
    [A] Major Client Engagements
      [A] The Sterling Group (Patagonia Trek)
        [F:53] Liam O'Connell landed The Sterling Group as a major new client for Voyage Vista Travel.
        [F:54] Voyage Vista Travel is developing a 14-day Andes Mountain Trek in Patagonia for The Sterling Group's
        [F:55] The Andes Mountain Trek for The Sterling Group is scheduled for May 2024.
      [A] Chen Family (Kenya Safari)
        [F:56] Voyage Vista Travel finalized a major booking with the Chen Family.
        [F:57] The Chen Family is looking for a 3-week luxury safari in Kenya for July 2024.
        [F:58] The safari for the Chen Family is a high-end, bespoke itinerary.
        [F:59] The safari for the Chen Family includes stays at Cottar's 1920s Camp.
        [F:60] The safari for the Chen Family includes stays at Angama Mara.
        [F:61] The safari for the Chen Family focuses on ethical wildlife viewing.
        [F:62] The safari for the Chen Family focuses on immersive cultural experiences.
        [F:63] The budget for the Chen Family's safari is approaching $75,000.
  [A] Destination & Product Development
    [A] Costa Rica Programs
      [A] Eco-Lodge Partnerships
        [A] Finca Verde (Prospective)
          [F:64] Voyage Vista Travel is looking at a partnership with a luxury eco-lodge in Costa Rica.
          [F:65] Voyage Vista Travel hopes to finalize a deal with Finca Verde for a launch by early 2024.
          [F:66] The partnership Voyage Vista Travel is looking at is for exclusive travel packages.
        [A] Casa Verde Eco-Resort (Finalized)
          [F:67] Voyage Vista finalized its partnership with Casa Verde Eco-Resort.
          [F:68] The partnership with Casa Verde Eco-Resort took months to finalize.
      [A] New Adventure Package Development
        [A] Package Design & Scope
          [F:69] Voyage Vista Travel plans to offer unique week-long excursions through the partnership with Finca Ve
          [F:70] Voyage Vista developed five exclusive new adventure packages.
        [A] Activity Inclusions
          [F:71] The new adventure packages include volcano trekking around Arenal.
          [F:72] The new adventure packages include white-water rafting on the Pacuare River.
          [F:73] The new adventure packages include cloud forest canopy tours.
          [F:74] The new adventure packages include sustainable coffee farm visits.
          [F:75] The new adventure packages include indigenous Bribri culture immersion.
      [A] Package Launch & Marketing
        [F:76] Voyage Vista is launching the new Costa Rica packages on its website on June 26, 2023.
        [F:77] Voyage Vista is doing a targeted social media campaign for the new Costa Rica packages.
    [A] Future & Diverse Destinations
      [F:78] Voyage Vista Travel has upcoming European tours planned for summer 2023.
      [F:79] Voyage Vista Travel is planning potential new South American itineraries.
  [A] Marketing & Brand Strategy
    [A] Digital Presence & Website
      [A] Website Redesign Project
        [A] Project Scope & Team
          [F:80] Liam O'Connell started working on a complete website redesign for Voyage Vista.
          [F:81] The Voyage Vista website redesign needs to better reflect expanded offerings.
          [F:82] The Voyage Vista website redesign needs to better reflect their new target audience.
          [F:83] Liam O'Connell brought in a freelance designer named Maria for the Voyage Vista website redesign.
        [A] Design & Launch Milestones
          [F:84] Maria specializes in travel industry sites.
          [F:85] Liam O'Connell is aiming for a beta launch of the Voyage Vista website redesign by mid-August 2023.
    [A] Content & Campaign Development
      [A] Sustainable Travel Guide
        [F:86] Liam O'Connell finished developing a new 'Sustainable Travel Guide' for Voyage Vista's clients.
        [F:87] The 'Sustainable Travel Guide' focuses on immersive local experiences.
        [F:88] The 'Sustainable Travel Guide' focuses on minimizing environmental impact.
        [F:89] The 'Sustainable Travel Guide' highlights destinations like Costa Rica's cloud forests.
        [F:90] The 'Sustainable Travel Guide' highlights destinations like Patagonia's conservation efforts.
      [A] Digital Marketing Campaigns
        [A] Instagram Campaign: Hidden Gems
          [F:91] Liam O'Connell is planning a new Instagram campaign for Voyage Vista called 'Hidden Gems of Costa Ri
          [F:92] The 'Hidden Gems of Costa Rica' campaign is planned for a Q1 2024 launch.
        [A] Luxury Eco-Tourism Campaign
          [F:93] Liam O'Connell and David Miller finalized a new marketing campaign for Voyage Vista Travel.
          [F:94] The new marketing campaign for Voyage Vista Travel targets luxury eco-tourism packages for the sprin
          [F:95] The new marketing campaign for Voyage Vista Travel is launching in early January 2024.
          [F:96] Voyage Vista Travel allocated $15,000 for digital ads for the new marketing campaign.
          [F:97] Voyage Vista Travel is launching a new digital marketing campaign for luxury eco-tourism on January
          [F:98] Voyage Vista Travel has a digital marketing launch scheduled for January 8, 2024.
    [A] Public Relations & Media
      [F:99] Voyage Vista Travel received a mention on the 'Bay Area Wanderlust' travel blog.
      [F:100] The mention on the 'Bay Area Wanderlust' travel blog drove a lot of traffic to Voyage Vista Travel's
  [A] Company Operations & Development
    [A] General Company Status
      [F:101] Things at Voyage Vista Travel are good.
    [A] Office & Infrastructure
      [A] New SOMA Office
        [A] Space Requirements
          [F:102] The new office space for Voyage Vista is intended to be in the SOMA district.
          [F:103] The new office space for Voyage Vista is hoped to be around 1500 sq ft.
          [F:104] The new office space for Voyage Vista is hoped to accommodate 8-10 people.
        [A] Lease & Occupancy Details
          [F:105] Liam O'Connell signed the lease for Voyage Vista Travel's 1600 sq ft SOMA office on Mission Street o
          [F:106] Voyage Vista Travel will get the keys to its new SOMA office on Mission Street on September 1, 2023.
    [A] Team & Personnel
      [A] Sarah Chen (Client Operations)
        [F:107] Sarah Chen will start working at Voyage Vista Travel on October 2, 2023.
        [F:108] Sarah Chen streamlined Voyage Vista Travel's client intake forms within her first 9 days of work.
        [F:109] Sarah Chen reorganized Voyage Vista Travel's client database within her first 9 days of work.
      [A] Chloe Davies (Consulting)
        [F:110] Chloe Davies is interested in helping with Voyage Vista Travel's social media strategy.
        [F:111] Chloe Davies might start as a consultant for Voyage Vista Travel by March 15, 2024.
    [A] Key Company Events
      [A] Grand Opening Event
        [A] Planning & Invitations
          [F:112] Voyage Vista Travel's grand opening is planned for October 12, 2023.
          [F:113] Voyage Vista Travel has sent out about 75 invitations for its grand opening.
          [F:114] The Voyage Vista Travel grand opening is scheduled for October 12, 2023.
          [F:115] Catering by Celeste confirmed their setup for 75 guests for the Voyage Vista Travel grand opening.
        [A] Event Execution & Impact
          [F:116] The Voyage Vista Travel grand opening was on October 12, 2023.
          [F:117] The Voyage Vista Travel grand opening was a huge success.
          [F:118] Over 120 people attended the Voyage Vista Travel grand opening throughout the day.
          [F:119] Catering by Celeste provided catering for the Voyage Vista Travel grand opening.
          [F:120] Voyage Vista Travel booked three new client consultations directly from its grand opening event.
          [F:121] Sarah Chen collected over 50 solid leads at the Voyage Vista Travel grand opening.
# teacher
# TEACHER-ENDPOINT tree task_id=46 entity='Company: Voyage Vista Travel' (oracle cache replay)
# facts=122 aspects=24 max_depth=6 avg_branching=5.84
# max_facts=0 replay_time=9.4s legacy_cache_key=auto persona=Company_Voyage_Vista_Travel
# cache: {"s1": {"hits": 313, "misses": 0, "puts": 0, "legacy_hits": 0}, "s2": {"hits": 132, "misses": 0, "puts": 0, "legacy_hits": 0}} oracle_fail_events=0
# teacher endpoint valid ONLY relative to cache_dir=/mnt/algo_code/zyli/2S_RL/runs/forest_v2/prod100_cache_5mini (audit R10: stale-teacher — regenerate after any prompt/payload change); misses below were answered by the LIVE vLLM (current teacher)

[ROOT] Voyage Vista Travel
  [F:101] Things at Voyage Vista Travel are good.
  [A] Program and Itinerary Planning
    [F:78] Voyage Vista Travel has upcoming European tours planned for summer 2023.
    [F:79] Voyage Vista Travel is planning potential new South American itineraries.
    [A] Synaptic Solutions adventure retreat
      [F:2] Voyage Vista Travel organized an adventure retreat for Synaptic Solutions.
      [F:3] The adventure retreat organized by Voyage Vista Travel was for 40 employees of Synaptic Solutions.
      [F:7] The adventure retreat organized by Voyage Vista Travel is worth over $75,000.
      [A] Trip duration, destination & dates
        [F:55] The Andes Mountain Trek for The Sterling Group is scheduled for May 2024.
        [F:57] The Chen Family is looking for a 3-week luxury safari in Kenya for July 2024.
        [F:71] The new adventure packages include volcano trekking around Arenal.
        [A] Synaptic Solutions retreat schedule & location
          [F:4] The adventure retreat organized by Voyage Vista Travel is a 5-day multi-activity trip.
          [F:5] The adventure retreat organized by Voyage Vista Travel is to the Costa Rican rainforest.
          [F:6] The adventure retreat organized by Voyage Vista Travel is scheduled for August 2023.
          [F:72] The new adventure packages include white-water rafting on the Pacuare River.
        [F:73] The new adventure packages include cloud forest canopy tours.
      [F:58] The safari for the Chen Family is a high-end, bespoke itinerary.
      [F:87] The 'Sustainable Travel Guide' focuses on immersive local experiences.
    [A] Tech-company retreat outreach
      [A] Proposal development and client meetings
        [F:1] Voyage Vista Travel plans to present proposals for corporate team-building retreats to local tech co
        [F:50] The follow-up meeting with Zenith Innovations is for a team-building retreat.
        [F:0] Voyage Vista Travel is brainstorming proposals for corporate team-building retreats.
        [F:47] The tasting event was for ten potential clients from various tech startups in Silicon Valley.
        [F:54] Voyage Vista Travel is developing a 14-day Andes Mountain Trek in Patagonia for The Sterling Group's
        [F:20] Voyage Vista Travel is proposing a week-long leadership and team-building retreat for TechSolutions
        [A] Syntel Systems corporate retreat program
          [F:14] The corporate retreat program for Syntel Systems includes guided hikes.
          [F:9] The corporate retreat program for Syntel Systems is for 50 employees.
          [F:10] The corporate retreat program for Syntel Systems is focused on team-building and leadership developm
          [F:23] Voyage Vista Travel is planning a 'build your own igloo' survival challenge for the TechSolutions In
          [F:29] The total project value for the TechSolutions Inc. corporate retreat is estimated at $120,000.
      [A] Schedule and location
        [F:30] The TechSolutions Inc. Whistler trip is scheduled for January 15, 2024.
        [F:31] Voyage Vista Travel hit a minor snag with ski and snowboard rentals for the TechSolutions Inc. Whist
        [A] Syntel Systems retreat (Aug 15-18, Redwood National Park)
          [F:11] The corporate retreat program for Syntel Systems is a four-day, three-night program.
          [F:12] The corporate retreat program for Syntel Systems is planned for Redwood National Park.
          [F:13] The corporate retreat program for Syntel Systems is scheduled for August 15th to August 18th.
          [F:15] The corporate retreat program for Syntel Systems includes a conservation project.
      [F:21] Voyage Vista Travel is planning guided backcountry skiing for the TechSolutions Inc. retreat.
      [F:22] Voyage Vista Travel is planning snowshoeing for the TechSolutions Inc. retreat.
    [A] Chen Family safari itinerary
      [F:59] The safari for the Chen Family includes stays at Cottar's 1920s Camp.
      [F:60] The safari for the Chen Family includes stays at Angama Mara.
      [F:61] The safari for the Chen Family focuses on ethical wildlife viewing.
      [F:62] The safari for the Chen Family focuses on immersive cultural experiences.
      [F:63] The budget for the Chen Family's safari is approaching $75,000.
    [F:70] Voyage Vista developed five exclusive new adventure packages.
    [A] Sustainable Travel Guide
      [F:86] Liam O'Connell finished developing a new 'Sustainable Travel Guide' for Voyage Vista's clients.
      [F:91] Liam O'Connell is planning a new Instagram campaign for Voyage Vista called 'Hidden Gems of Costa Ri
      [F:92] The 'Hidden Gems of Costa Rica' campaign is planned for a Q1 2024 launch.
      [A] Environmental focus and featured destinations
        [F:88] The 'Sustainable Travel Guide' focuses on minimizing environmental impact.
        [F:89] The 'Sustainable Travel Guide' highlights destinations like Costa Rica's cloud forests.
        [F:90] The 'Sustainable Travel Guide' highlights destinations like Patagonia's conservation efforts.
      [F:69] Voyage Vista Travel plans to offer unique week-long excursions through the partnership with Finca Ve
      [F:74] The new adventure packages include sustainable coffee farm visits.
      [F:75] The new adventure packages include indigenous Bribri culture immersion.
      [F:41] The first 'Peruvian Highlands Trek' group for Voyage Vista Travel's EcoTrek Adventures partnership i
    [F:43] The 'Peruvian Highlands Trek' group departs on April 10, 2024.
    [F:44] The 'Peruvian Highlands Trek' group's departure is scheduled for April 10, 2024.
  [A] Sales and Partnerships
    [A] Client wins and closed opportunities
      [A] Closed client wins
        [A] Syntel Systems corporate contract
          [F:17] The contract with Syntel Systems positions Voyage Vista for more corporate work.
          [F:8] Voyage Vista landed a massive corporate retreat program with Syntel Systems.
          [F:16] The contract with Syntel Systems is a significant revenue boost for Voyage Vista.
        [A] Major client and partner closures
          [F:67] Voyage Vista finalized its partnership with Casa Verde Eco-Resort.
          [F:68] The partnership with Casa Verde Eco-Resort took months to finalize.
          [F:39] The 'Sustainable Safaris' partnership with EcoTrek Adventures closed on January 31, 2024.
          [F:40] The 'Sustainable Safaris' partnership with EcoTrek Adventures met its $150,000 first-year goal.
          [A] Notable client contracts
            [F:26] Voyage Vista Travel landed the TechSolutions Inc. contract for their corporate retreat in Whistler.
            [F:53] Liam O'Connell landed The Sterling Group as a major new client for Voyage Vista Travel.
            [F:56] Voyage Vista Travel finalized a major booking with the Chen Family.
          [F:28] Voyage Vista Travel received an initial deposit of $45,000 for the TechSolutions Inc. corporate retr
          [F:37] Voyage Vista Travel closed a significant deal.
          [F:36] Voyage Vista Travel finalized Whistler Blackcomb Gear Rentals on December 28, 2023.
        [F:120] Voyage Vista Travel booked three new client consultations directly from its grand opening event.
        [F:18] Voyage Vista Travel landed its first big proposal for corporate team-building retreats.
        [F:42] Voyage Vista Travel has secured 8 bookings out of 12 available spots for the first 'Peruvian Highlan
      [F:64] Voyage Vista Travel is looking at a partnership with a luxury eco-lodge in Costa Rica.
      [F:65] Voyage Vista Travel hopes to finalize a deal with Finca Verde for a launch by early 2024.
      [F:108] Sarah Chen streamlined Voyage Vista Travel's client intake forms within her first 9 days of work.
      [F:109] Sarah Chen reorganized Voyage Vista Travel's client database within her first 9 days of work.
      [A] Prospective enterprise clients
        [F:49] Voyage Vista Travel secured a follow-up meeting with Zenith Innovations.
        [F:51] Securing Salesforce as a client would be huge for Voyage Vista Travel.
        [F:52] Securing Google as a client would be huge for Voyage Vista Travel.
        [A] TechSolutions Inc. opportunity
          [F:33] Alpine Peak Sports could not provide 45 sets of premium gear for the TechSolutions Inc. Whistler tri
          [F:19] Voyage Vista Travel's first big proposal is with TechSolutions Inc.
          [F:27] The meeting for the TechSolutions Inc. contract happened on November 17, 2023.
      [F:24] Voyage Vista Travel is working on the final proposal for TechSolutions Inc. during the week of Novem
      [F:25] Voyage Vista Travel is aiming for a client meeting with TechSolutions Inc. on November 17, 2023.
      [F:38] The deal confirms Voyage Vista Travel's niche in high-end corporate adventure travel.
      [F:34] Voyage Vista Travel secured a bulk deal with Whistler Blackcomb Gear Rentals for the ski and snowboa
      [F:32] Voyage Vista Travel's original vendor for ski and snowboard rentals was Alpine Peak Sports.
      [F:35] The deal with Whistler Blackcomb Gear Rentals was at a 5% higher cost than the original vendor.
    [A] Marketing and Promotion
      [F:66] The partnership Voyage Vista Travel is looking at is for exclusive travel packages.
      [A] Social media strategy and staffing
        [F:77] Voyage Vista is doing a targeted social media campaign for the new Costa Rica packages.
        [F:110] Chloe Davies is interested in helping with Voyage Vista Travel's social media strategy.
        [F:111] Chloe Davies might start as a consultant for Voyage Vista Travel by March 15, 2024.
        [F:99] Voyage Vista Travel received a mention on the 'Bay Area Wanderlust' travel blog.
        [F:100] The mention on the 'Bay Area Wanderlust' travel blog drove a lot of traffic to Voyage Vista Travel's
        [F:96] Voyage Vista Travel allocated $15,000 for digital ads for the new marketing campaign.
        [A] Campaign planning and targets
          [F:95] The new marketing campaign for Voyage Vista Travel is launching in early January 2024.
          [F:93] Liam O'Connell and David Miller finalized a new marketing campaign for Voyage Vista Travel.
          [F:94] The new marketing campaign for Voyage Vista Travel targets luxury eco-tourism packages for the sprin
          [F:97] Voyage Vista Travel is launching a new digital marketing campaign for luxury eco-tourism on January
          [F:98] Voyage Vista Travel has a digital marketing launch scheduled for January 8, 2024.
        [F:113] Voyage Vista Travel has sent out about 75 invitations for its grand opening.
        [F:45] The promotional materials for the 'Peruvian Highlands Trek' need to be ready by February 21, 2024.
      [A] Website redesign and specialists
        [F:85] Liam O'Connell is aiming for a beta launch of the Voyage Vista website redesign by mid-August 2023.
        [F:82] The Voyage Vista website redesign needs to better reflect their new target audience.
        [F:84] Maria specializes in travel industry sites.
        [F:76] Voyage Vista is launching the new Costa Rica packages on its website on June 26, 2023.
      [F:117] The Voyage Vista Travel grand opening was a huge success.
      [F:118] Over 120 people attended the Voyage Vista Travel grand opening throughout the day.
      [F:119] Catering by Celeste provided catering for the Voyage Vista Travel grand opening.
      [F:121] Sarah Chen collected over 50 solid leads at the Voyage Vista Travel grand opening.
  [F:107] Sarah Chen will start working at Voyage Vista Travel on October 2, 2023.
  [F:80] Liam O'Connell started working on a complete website redesign for Voyage Vista.
  [F:83] Liam O'Connell brought in a freelance designer named Maria for the Voyage Vista website redesign.
  [F:102] The new office space for Voyage Vista is intended to be in the SOMA district.
  [F:103] The new office space for Voyage Vista is hoped to be around 1500 sq ft.
  [F:104] The new office space for Voyage Vista is hoped to accommodate 8-10 people.
  [F:105] Liam O'Connell signed the lease for Voyage Vista Travel's 1600 sq ft SOMA office on Mission Street o
  [F:106] Voyage Vista Travel will get the keys to its new SOMA office on Mission Street on September 1, 2023.
  [F:46] Voyage Vista Travel hosted a successful tasting event on June 01, 2023.
  [F:48] The tasting event featured ceviche and Pisco Sours.
  [F:81] The Voyage Vista website redesign needs to better reflect expanded offerings.
  [F:115] Catering by Celeste confirmed their setup for 75 guests for the Voyage Vista Travel grand opening.
  [F:116] The Voyage Vista Travel grand opening was on October 12, 2023.
  [F:112] Voyage Vista Travel's grand opening is planned for October 12, 2023.
  [F:114] The Voyage Vista Travel grand opening is scheduled for October 12, 2023.
# POLICY-GROWN tree task_id=46 entity='Company: Voyage Vista Travel' (S1=ckpt_epoch39.pt, S2=ckpt_epoch39.pt, decode_prior_tau=0.0)
# facts=122 aspects=24 max_depth=8 avg_branching=5.84
# s2_rounds=122 decode_rows=960 | GROUP_rows=114 (group_events=24) DOWN=0 UP=0 IDLE=846 (idle_frac=0.881) | s1_navs=422 apply_errors=0
# max_facts=0 rollout_time=10.4s reference: tree_46_reference.txt
# R10 pairF1(policy,teacher)=0.1385 [flat-null=0.0915] n_common=122 teacher(aspects=24 depth=6) teacher_vs_ref_pairF1=0.2737
# R10 pairF1(policy,reference)=0.3477 [flat-null=0.0569] n_common=122
# R10 policy depth_hist={1: 2, 2: 6, 3: 15, 4: 46, 5: 41, 6: 3, 7: 5, 8: 4} longest_1child_chain=0 aspect_edges=24 same_name_ratio=0.000 high_sim(cos>0.9)_ratio=0.000

[ROOT] Voyage Vista Travel
  [F:78] Voyage Vista Travel has upcoming European tours planned for summer 2023.
  [F:0] Voyage Vista Travel is brainstorming proposals for corporate team-building retreats.
  [A] Positive Business Momentum
    [F:101] Things at Voyage Vista Travel are good.
    [F:1] Voyage Vista Travel plans to present proposals for corporate team-building retreats to local tech co
    [A] Media Coverage and Itinerary Expansion
      [F:7] The adventure retreat organized by Voyage Vista Travel is worth over $75,000.
      [F:47] The tasting event was for ten potential clients from various tech startups in Silicon Valley.
      [A] Blog Mention and Retreats
        [F:79] Voyage Vista Travel is planning potential new South American itineraries.
        [F:99] Voyage Vista Travel received a mention on the 'Bay Area Wanderlust' travel blog.
        [F:100] The mention on the 'Bay Area Wanderlust' travel blog drove a lot of traffic to Voyage Vista Travel's
        [F:6] The adventure retreat organized by Voyage Vista Travel is scheduled for August 2023.
      [F:49] Voyage Vista Travel secured a follow-up meeting with Zenith Innovations.
      [F:52] Securing Google as a client would be huge for Voyage Vista Travel.
      [A] Client Acquisition and Retreats
        [F:50] The follow-up meeting with Zenith Innovations is for a team-building retreat.
        [F:51] Securing Salesforce as a client would be huge for Voyage Vista Travel.
        [F:27] The meeting for the TechSolutions Inc. contract happened on November 17, 2023.
        [F:29] The total project value for the TechSolutions Inc. corporate retreat is estimated at $120,000.
        [F:30] The TechSolutions Inc. Whistler trip is scheduled for January 15, 2024.
      [F:55] The Andes Mountain Trek for The Sterling Group is scheduled for May 2024.
    [F:5] The adventure retreat organized by Voyage Vista Travel is to the Costa Rican rainforest.
    [A] Corporate Adventure Retreats
      [F:2] Voyage Vista Travel organized an adventure retreat for Synaptic Solutions.
      [F:3] The adventure retreat organized by Voyage Vista Travel was for 40 employees of Synaptic Solutions.
      [F:4] The adventure retreat organized by Voyage Vista Travel is a 5-day multi-activity trip.
      [F:48] The tasting event featured ceviche and Pisco Sours.
    [F:37] Voyage Vista Travel closed a significant deal.
    [F:38] The deal confirms Voyage Vista Travel's niche in high-end corporate adventure travel.
    [F:60] The safari for the Chen Family includes stays at Angama Mara.
    [A] Luxury Bespoke Itineraries
      [F:46] Voyage Vista Travel hosted a successful tasting event on June 01, 2023.
      [F:53] Liam O'Connell landed The Sterling Group as a major new client for Voyage Vista Travel.
      [F:86] Liam O'Connell finished developing a new 'Sustainable Travel Guide' for Voyage Vista's clients.
      [A] Kenya Luxury Safari
        [F:57] The Chen Family is looking for a 3-week luxury safari in Kenya for July 2024.
        [F:58] The safari for the Chen Family is a high-end, bespoke itinerary.
        [F:59] The safari for the Chen Family includes stays at Cottar's 1920s Camp.
        [F:61] The safari for the Chen Family focuses on ethical wildlife viewing.
        [F:62] The safari for the Chen Family focuses on immersive cultural experiences.
        [F:63] The budget for the Chen Family's safari is approaching $75,000.
        [F:76] Voyage Vista is launching the new Costa Rica packages on its website on June 26, 2023.
        [F:77] Voyage Vista is doing a targeted social media campaign for the new Costa Rica packages.
      [A] Patagonia Executive Trek
        [F:54] Voyage Vista Travel is developing a 14-day Andes Mountain Trek in Patagonia for The Sterling Group's
        [F:56] Voyage Vista Travel finalized a major booking with the Chen Family.
      [F:111] Chloe Davies might start as a consultant for Voyage Vista Travel by March 15, 2024.
      [F:8] Voyage Vista landed a massive corporate retreat program with Syntel Systems.
      [A] Sustainable Travel Operations
        [F:87] The 'Sustainable Travel Guide' focuses on immersive local experiences.
        [F:88] The 'Sustainable Travel Guide' focuses on minimizing environmental impact.
        [F:89] The 'Sustainable Travel Guide' highlights destinations like Costa Rica's cloud forests.
        [F:90] The 'Sustainable Travel Guide' highlights destinations like Patagonia's conservation efforts.
        [A] New Hire Onboarding
          [F:107] Sarah Chen will start working at Voyage Vista Travel on October 2, 2023.
          [F:108] Sarah Chen streamlined Voyage Vista Travel's client intake forms within her first 9 days of work.
          [F:72] The new adventure packages include white-water rafting on the Pacuare River.
        [A] Cultural Immersion Marketing
          [F:110] Chloe Davies is interested in helping with Voyage Vista Travel's social media strategy.
          [F:75] The new adventure packages include indigenous Bribri culture immersion.
        [F:84] Maria specializes in travel industry sites.
        [A] Digital Platform Expansion
          [F:109] Sarah Chen reorganized Voyage Vista Travel's client database within her first 9 days of work.
          [F:73] The new adventure packages include cloud forest canopy tours.
          [F:74] The new adventure packages include sustainable coffee farm visits.
          [F:80] Liam O'Connell started working on a complete website redesign for Voyage Vista.
          [F:81] The Voyage Vista website redesign needs to better reflect expanded offerings.
          [F:82] The Voyage Vista website redesign needs to better reflect their new target audience.
          [F:83] Liam O'Connell brought in a freelance designer named Maria for the Voyage Vista website redesign.
        [A] Voyage Vista Marketing Initiatives
          [F:94] The new marketing campaign for Voyage Vista Travel targets luxury eco-tourism packages for the sprin
          [F:98] Voyage Vista Travel has a digital marketing launch scheduled for January 8, 2024.
          [A] Liam O'Connell Projects
            [F:114] The Voyage Vista Travel grand opening is scheduled for October 12, 2023.
            [A] Voyage Vista Launch Plans
              [F:112] Voyage Vista Travel's grand opening is planned for October 12, 2023.
              [F:35] The deal with Whistler Blackcomb Gear Rentals was at a 5% higher cost than the original vendor.
              [A] Marketing Campaigns
                [F:85] Liam O'Connell is aiming for a beta launch of the Voyage Vista website redesign by mid-August 2023.
                [F:91] Liam O'Connell is planning a new Instagram campaign for Voyage Vista called 'Hidden Gems of Costa Ri
                [F:92] The 'Hidden Gems of Costa Rica' campaign is planned for a Q1 2024 launch.
                [F:93] Liam O'Connell and David Miller finalized a new marketing campaign for Voyage Vista Travel.
            [F:116] The Voyage Vista Travel grand opening was on October 12, 2023.
            [F:26] Voyage Vista Travel landed the TechSolutions Inc. contract for their corporate retreat in Whistler.
            [A] TechSolutions Inc. Proposal
              [F:18] Voyage Vista Travel landed its first big proposal for corporate team-building retreats.
              [F:24] Voyage Vista Travel is working on the final proposal for TechSolutions Inc. during the week of Novem
              [F:25] Voyage Vista Travel is aiming for a client meeting with TechSolutions Inc. on November 17, 2023.
          [F:120] Voyage Vista Travel booked three new client consultations directly from its grand opening event.
          [F:31] Voyage Vista Travel hit a minor snag with ski and snowboard rentals for the TechSolutions Inc. Whist
          [F:32] Voyage Vista Travel's original vendor for ski and snowboard rentals was Alpine Peak Sports.
          [F:34] Voyage Vista Travel secured a bulk deal with Whistler Blackcomb Gear Rentals for the ski and snowboa
          [F:36] Voyage Vista Travel finalized Whistler Blackcomb Gear Rentals on December 28, 2023.
          [F:42] Voyage Vista Travel has secured 8 bookings out of 12 available spots for the first 'Peruvian Highlan
        [A] Grand Opening Logistics
          [F:95] The new marketing campaign for Voyage Vista Travel is launching in early January 2024.
          [F:96] Voyage Vista Travel allocated $15,000 for digital ads for the new marketing campaign.
          [F:97] Voyage Vista Travel is launching a new digital marketing campaign for luxury eco-tourism on January
          [F:113] Voyage Vista Travel has sent out about 75 invitations for its grand opening.
          [F:115] Catering by Celeste confirmed their setup for 75 guests for the Voyage Vista Travel grand opening.
        [F:23] Voyage Vista Travel is planning a 'build your own igloo' survival challenge for the TechSolutions In
        [A] Corporate Retreat Planning
          [F:117] The Voyage Vista Travel grand opening was a huge success.
          [F:118] Over 120 people attended the Voyage Vista Travel grand opening throughout the day.
          [F:119] Catering by Celeste provided catering for the Voyage Vista Travel grand opening.
          [F:121] Sarah Chen collected over 50 solid leads at the Voyage Vista Travel grand opening.
          [F:20] Voyage Vista Travel is proposing a week-long leadership and team-building retreat for TechSolutions
          [F:21] Voyage Vista Travel is planning guided backcountry skiing for the TechSolutions Inc. retreat.
          [F:22] Voyage Vista Travel is planning snowshoeing for the TechSolutions Inc. retreat.
          [F:33] Alpine Peak Sports could not provide 45 sets of premium gear for the TechSolutions Inc. Whistler tri
        [F:41] The first 'Peruvian Highlands Trek' group for Voyage Vista Travel's EcoTrek Adventures partnership i
        [F:43] The 'Peruvian Highlands Trek' group departs on April 10, 2024.
        [F:44] The 'Peruvian Highlands Trek' group's departure is scheduled for April 10, 2024.
        [F:45] The promotional materials for the 'Peruvian Highlands Trek' need to be ready by February 21, 2024.
      [A] Syntel Leadership Retreat
        [F:9] The corporate retreat program for Syntel Systems is for 50 employees.
        [F:10] The corporate retreat program for Syntel Systems is focused on team-building and leadership developm
        [F:11] The corporate retreat program for Syntel Systems is a four-day, three-night program.
        [F:12] The corporate retreat program for Syntel Systems is planned for Redwood National Park.
        [F:13] The corporate retreat program for Syntel Systems is scheduled for August 15th to August 18th.
        [F:14] The corporate retreat program for Syntel Systems includes guided hikes.
      [A] Syntel and EcoTrek Partnerships
        [F:102] The new office space for Voyage Vista is intended to be in the SOMA district.
        [A] Syntel and EcoTrek Outcomes
          [F:15] The corporate retreat program for Syntel Systems includes a conservation project.
          [F:16] The contract with Syntel Systems is a significant revenue boost for Voyage Vista.
          [F:17] The contract with Syntel Systems positions Voyage Vista for more corporate work.
          [F:39] The 'Sustainable Safaris' partnership with EcoTrek Adventures closed on January 31, 2024.
          [F:40] The 'Sustainable Safaris' partnership with EcoTrek Adventures met its $150,000 first-year goal.
        [F:103] The new office space for Voyage Vista is hoped to be around 1500 sq ft.
        [F:104] The new office space for Voyage Vista is hoped to accommodate 8-10 people.
        [F:19] Voyage Vista Travel's first big proposal is with TechSolutions Inc.
        [A] Voyage Vista Office Lease
          [F:105] Liam O'Connell signed the lease for Voyage Vista Travel's 1600 sq ft SOMA office on Mission Street o
          [F:106] Voyage Vista Travel will get the keys to its new SOMA office on Mission Street on September 1, 2023.
          [F:28] Voyage Vista Travel received an initial deposit of $45,000 for the TechSolutions Inc. corporate retr
      [F:71] The new adventure packages include volcano trekking around Arenal.
      [A] Eco-Resort Partnerships
        [F:64] Voyage Vista Travel is looking at a partnership with a luxury eco-lodge in Costa Rica.
        [F:65] Voyage Vista Travel hopes to finalize a deal with Finca Verde for a launch by early 2024.
        [F:66] The partnership Voyage Vista Travel is looking at is for exclusive travel packages.
        [F:67] Voyage Vista finalized its partnership with Casa Verde Eco-Resort.
        [F:68] The partnership with Casa Verde Eco-Resort took months to finalize.
        [F:69] Voyage Vista Travel plans to offer unique week-long excursions through the partnership with Finca Ve
        [F:70] Voyage Vista developed five exclusive new adventure packages.